डेटा इंजीनियर इंटरव्यू तीन चीज़ें परखते हैं: SQL, आप डेटा पाइपलाइन कैसे डिज़ाइन और चलाते हैं, और आप स्केल तथा फेल्योर के बारे में कैसे सोचते हैं। नीचे 20 सवाल उनके जवाबों के साथ दिए गए हैं, जिन्हें आप अपने हिसाब से ढाल सकते हैं—उसी क्रम में जिसमें उम्मीदवार आमतौर पर इनसे टकराते हैं। SQL के उदाहरणों को प्रकाशन से पहले एक छोटे सैंपल डेटाबेस पर चलाया गया था, और दिखाए गए नतीजे असली आउटपुट हैं।
SQL सवाल
1. हर कंपनी में या कुल मिलाकर दूसरा सबसे ज़्यादा वेतन निकालें
DENSE_RANK इस्तेमाल करें, ताकि बराबर वेतन वालों को एक ही रैंक मिले और "दूसरा सबसे ज़्यादा" का मतलब दूसरा अलग मान हो।
SELECT name, salary
FROM (
  SELECT name, salary, DENSE_RANK() OVER (ORDER BY salary DESC) AS r
  FROM employees
) t
WHERE r = 2;
150, 130, 130, 110, 90, 70 वेतन वाली टेबल पर यह उन दो लोगों को लौटाता है जिन्हें 130 मिलते हैं। बताएं कि आपने DENSE_RANK को RANK (जो बराबरी के बाद नंबर छोड़ देता है) और ROW_NUMBER (जो बराबरी को मनमाने ढंग से तोड़ता है) पर क्यों चुना।
2. हर डिपार्टमेंट में टॉप दो कमाने वाले
SELECT dept, name, salary
FROM (
  SELECT dept, name, salary,
         RANK() OVER (PARTITION BY dept ORDER BY salary DESC) AS r
  FROM employees
) t
WHERE r <= 2;
PARTITION BY हर डिपार्टमेंट के लिए रैंकिंग फिर से शुरू करता है। यह भी बताएं कि RANK के साथ बराबर वेतन होने पर दो से ज़्यादा पंक्तियाँ आ सकती हैं।
3. हर ग्राहक के लिए रनिंग टोटल
SELECT customer, order_date, amount,
       SUM(amount) OVER (PARTITION BY customer ORDER BY order_date) AS running_total
FROM orders;
बढ़ती तारीखों पर 10, 20 और 30 के ऑर्डर वाले ग्राहक के लिए रनिंग टोटल 10, 30 और 60 होंगे।
4. डुप्लीकेट पंक्तियाँ हटाएं, पहली वाली रखें
SELECT id, user_id
FROM (
  SELECT id, user_id,
         ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY id) AS rn
  FROM events
) t
WHERE rn = 1;
यहाँ ROW_NUMBER सही है, क्योंकि आपको हर ग्रुप में ठीक एक पंक्ति चाहिए। तैयार रहें कि असली टेबल में कौन-सा डुप्लीकेट रखना है यह आप कैसे तय करेंगे (सबसे नया टाइमस्टैम्प, सबसे पूरा रिकॉर्ड)।
5. पिछली पंक्ति से बदलाव
SELECT order_date, amount,
       amount - LAG(amount) OVER (ORDER BY order_date) AS change
FROM orders
WHERE customer = 'A';
पहली पंक्ति का बदलाव NULL है, क्योंकि उससे पहले कोई पंक्ति नहीं है। इसे ज़ोर से कहें, क्योंकि अगला सवाल आमतौर पर यही होता है।
6. WHERE और HAVING में क्या फर्क है?
WHERE ग्रुपिंग से पहले पंक्तियों को फ़िल्टर करता है, और HAVING एग्रीगेशन के बाद ग्रुप को फ़िल्टर करता है। WHERE में COUNT(*) जैसा एग्रीगेट इस्तेमाल नहीं कर सकते।
7. धीमी क्वेरी को तेज़ कैसे करेंगे?
- कुछ भी बदलने से पहले क्वेरी प्लान देखें।
- जाँचें कि फ़िल्टर इंडेक्स इस्तेमाल कर पा रहे हैं, और कॉलम पर लगे फंक्शन उसे रोक नहीं रहे।
- स्कैन होने वाला डेटा कम करें: सिर्फ़ ज़रूरी कॉलम चुनें, जल्दी फ़िल्टर करें, और बड़ी टेबल को तारीख के हिसाब से पार्टिशन करें।
- बार-बार दोहराए जाने वाले सबक्वेरी को जॉइन या कॉमन टेबल एक्सप्रेशन से बदलें, और जॉइन में गलती से पंक्तियाँ बढ़ तो नहीं रहीं यह देखें।
- वेयरहाउस के लिए, क्लस्टरिंग या सॉर्ट की और हर क्वेरी कितना डेटा पढ़ती है, यह जाँचें।
पाइपलाइन डिज़ाइन के सवाल
8. ETL या ELT?
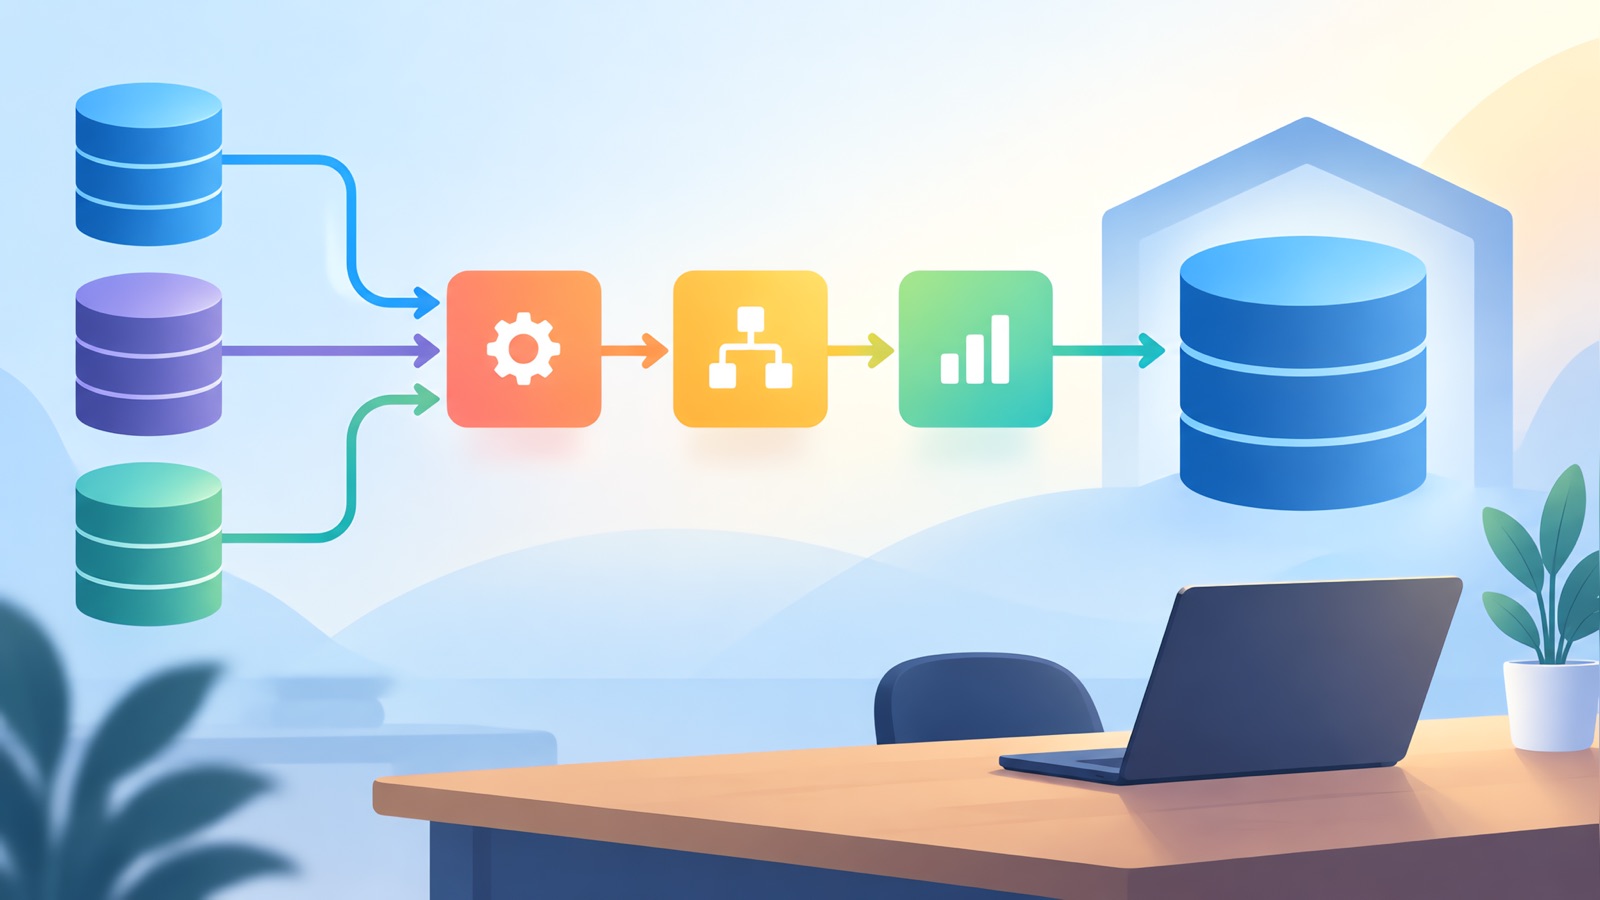
ETL डेटा लोड करने से पहले उसे ट्रांसफ़ॉर्म करता है। ELT पहले कच्चा डेटा लोड करता है और उसे वेयरहाउस के अंदर ट्रांसफ़ॉर्म करता है। क्लाउड वेयरहाउस के साथ ELT आम है क्योंकि स्टोरेज सस्ता है, कच्चा डेटा दोबारा प्रोसेस करने के लिए उपलब्ध रहता है, और ट्रांसफ़ॉर्मेशन को SQL के रूप में वर्ज़न किया जा सकता है। ETL तब भी समझ में आता है जब डेटा के लैंड होने से पहले उसे साफ़ या मास्क करना ज़रूरी हो, जैसे पर्सनल डेटा हटाने के लिए।
9. बैच या स्ट्रीमिंग?
डेटा कितना ताज़ा होना चाहिए, इसके हिसाब से चुनें। बैच ज़्यादा आसान और सस्ता है और रोज़ की रिपोर्ट के लिए फिट बैठता है। स्ट्रीमिंग उन मामलों के लिए है जहाँ मिनट या सेकंड मायने रखते हैं, जैसे फ्रॉड चेक या लाइव डैशबोर्ड। कई सिस्टम दोनों इस्तेमाल करते हैं। सिर्फ़ टेक्नोलॉजी नहीं, यह बताएं कि बिज़नेस फ़ैसला क्या है।
10. इडेम्पोटेंट पाइपलाइन क्या है, और यह क्यों मायने रखती है?
इसे दो बार चलाने पर वही नतीजा मिलता है जो एक बार चलाने पर मिलता है। यह इसलिए मायने रखता है क्योंकि जॉब फेल होती हैं और दोबारा चलाई जाती हैं। लोड को इडेम्पोटेंट बनाने के लिए, पार्टिशन के हिसाब से लिखें और उस पार्टिशन को ओवरराइट करें, या स्थिर की के साथ अपसर्ट करें, ताकि रीट्राई से डुप्लीकेट न बनें।
11. देर से आने वाले या क्रम से बाहर के डेटा को कैसे संभालेंगे?
आगमन समय की जगह इवेंट टाइम इस्तेमाल करें, और तय करें कि डेटा कितनी देर से आ सकता है। स्ट्रीमिंग सिस्टम में, वॉटरमार्क जॉब को बताता है कि विंडो बंद करने से पहले कितनी देर इंतज़ार करना है। बैच टेबल के लिए, हाल के पार्टिशन को तय शेड्यूल पर दोबारा प्रोसेस करें, या एक करेक्शन प्रोसेस रखें जो प्रभावित दिनों को फिर से लिख दे।
12. फेल्योर और रीट्राई के लिए डिज़ाइन कैसे करेंगे?
स्टेप छोटे, इडेम्पोटेंट और अलग से दोबारा चलाए जा सकने वाले रखें। स्टेट जॉब के बाहर रखें। एरर के साथ-साथ गुम या देर से आने वाले डेटा पर भी अलर्ट लगाएं। रीट्राई की सीमा तय करें, और बार-बार फेल होने वाली चीज़ों को ऐसी जगह भेजें जहाँ कोई इंसान देखे।
13. डेटा क्वालिटी कैसे जाँचेंगे?
| जाँच | उदाहरण |
|---|---|
| पूर्णता | पंक्तियों की गिनती एक सह्यता के भीतर सोर्स से मेल खाती है |
| विशिष्टता | प्राइमरी की में कोई डुप्लीकेट नहीं है |
| वैधता | मान अपेक्षित रेंज या सेट में आते हैं |
| ताज़गी | सबसे नया टाइमस्टैम्प काफ़ी हाल का है |
| सुसंगतता | जुड़ी टेबलों में टोटल मेल खाते हैं |
जाँच पाइपलाइन के अंदर चलाएं और जल्दी फेल करें, ताकि खराब डेटा रिपोर्ट तक न पहुँचे।
मॉडलिंग और स्टोरेज से जुड़े सवाल
14. स्टार स्कीमा क्या है?
एक केंद्रीय फैक्ट टेबल में मापे जा सकने वाले इवेंट्स होते हैं, जैसे ऑर्डर, और यह उन्हें बताने वाली डाइमेंशन टेबल्स से जुड़ी होती है, जैसे कस्टमर, प्रोडक्ट और डेट। इसे क्वेरी करना आसान और एग्रीगेट करना तेज़ होता है। स्नोफ्लेक स्कीमा डाइमेंशन्स को और नॉर्मलाइज़ करता है, जिससे जगह बचती है लेकिन जॉइन्स बढ़ जाते हैं।
15. स्लोली चेंजिंग डाइमेंशन्स क्या हैं?
ये ऐसी डाइमेंशन एट्रिब्यूट्स हैं जो समय के साथ बदलती हैं, जैसे किसी कस्टमर का पता। Type 1 पुरानी वैल्यू को ओवरराइट कर देता है और हिस्ट्री खो देता है। Type 2 स्टार्ट और एंड डेट के साथ नई रो जोड़ता है, जिससे हिस्ट्री बनी रहती है। बताइए कि किस एट्रिब्यूट के लिए कौन-सा चुनेंगे और क्यों।
16. बड़ी टेबल को पार्टिशन कैसे करेंगे?
उस कॉलम पर पार्टिशन करें जिस पर ज़्यादातर क्वेरीज़ फ़िल्टर करती हैं, आमतौर पर डेट। जो क्वेरीज़ उस पर फ़िल्टर करती हैं, वे सिर्फ़ मैच करने वाले पार्टिशन्स पढ़ती हैं। ऐसे कॉलम से बचें जिसमें बहुत ज़्यादा अलग-अलग वैल्यूज़ हों, क्योंकि इससे बहुत सारे छोटे-छोटे पार्टिशन्स बन जाते हैं।
17. एनालिटिक्स के लिए कौन-से फ़ाइल फ़ॉर्मैट इस्तेमाल करते हैं, और क्यों?
Parquet जैसे कॉलमर फ़ॉर्मैट हर कॉलम को साथ-साथ स्टोर करते हैं, इसलिए जो क्वेरीज़ कुछ ही कॉलम पढ़ती हैं वे बाकी को छोड़ देती हैं और अच्छी तरह कंप्रेस हो जाती हैं। CSV या JSON जैसे रो फ़ॉर्मैट बनाने और पढ़ने में आसान हैं, लेकिन बड़े स्केल पर धीमे और भारी हो जाते हैं।
डिस्ट्रीब्यूटेड प्रोसेसिंग से जुड़े सवाल
18. Spark में शफ़ल क्या है, और यह महंगा क्यों है?
शफ़ल डेटा को मशीनों के बीच ले जाता है ताकि एक ही की वाली रो एक साथ आ जाएँ, जैसे जॉइन्स और group-bys में। इसमें नेटवर्क ट्रांसफ़र, डिस्क राइट और सॉर्टिंग का खर्च आता है। इसे कम करने के लिए जल्दी फ़िल्टर करें, समझदारी से पार्टिशन काउंट चुनें, और जॉइन में छोटी टेबल को ब्रॉडकास्ट करें ताकि बड़ी टेबल को हिलना न पड़े।
19. डेटा स्क्यू को कैसे हैंडल करेंगे?
स्क्यू का मतलब है कि कुछ कीज़ में ज़्यादातर डेटा होता है, इसलिए एक टास्क बाकी सबसे कहीं ज़्यादा देर तक चलता है। विकल्पों में हॉट की में रैंडम सफ़िक्स जोड़कर सॉल्टिंग करना और दो बार एग्रीगेट करना, जॉइन के छोटे साइड को ब्रॉडकास्ट करना, और हॉट कीज़ को अलग से फ़िल्टर या हैंडल करना शामिल है।
20. Airflow जैसा ऑर्केस्ट्रेटर क्या करता है?
यह टास्क को क्रम में शेड्यूल और रन करता है, जिसे एक डायरेक्टेड ग्राफ़ के रूप में परिभाषित किया जाता है जहाँ हर टास्क दूसरों पर निर्भर करता है। यह रिट्राइज़, बैकफ़िल्स और अलर्ट्स संभालता है, और दिखाता है कि क्या चला और क्या फेल हुआ। यह काम को कोऑर्डिनेट करता है। इसे खुद भारी प्रोसेसिंग करने के लिए नहीं बनाया गया है, वह किसी वेयरहाउस या प्रोसेसिंग इंजन में चलनी चाहिए।
तैयारी कैसे करें
- ऊपर दिए विंडो फ़ंक्शन पैटर्न्स को तब तक प्रैक्टिस करें जब तक आप उन्हें बिना देखे लिख न सकें।
- एक पाइपलाइन तैयार रखें जो आपने बनाई हो, उसके वॉल्यूम, आपने जो फेल्योर देखे और आपने क्या बदला, के साथ।
- तैयार रहें कि व्हाइटबोर्ड पर एक सिंपल आर्किटेक्चर बना सकें और बता सकें कि कोई स्टेप फेल होने पर क्या होता है।
- अपना रिज़्यूमे दोबारा देखें: उसमें लिखे हर टूल के बारे में सवाल पूछा जा सकता है।
इससे जुड़ी प्रैक्टिस के लिए, हमारी गाइड देखें: Kafka interview questions, Databricks interview questions, Snowflake interview questions, और system design interview questions।
ज़ोर से और अपने शब्दों में प्रैक्टिस करें। बाद में एक ट्रांसक्रिप्ट दिखाता है कि आपने कहाँ भटकाव किया या मुख्य बात छोड़ दी। किसी भी लाइव इंटरव्यू या असेसमेंट में AI टूल्स को लेकर एम्प्लॉयर के नियमों का पालन करें।
YesToTheOffer के साथ अपने उत्तरों का अभ्यास करें
जोर से अभ्यास करें, अपने ही रिज्यूमे से उत्तर प्राप्त करें, और बाद में अपने ट्रांसक्रिप्ट की समीक्षा करें। 30 मुफ्त मिनट, कोई सदस्यता नहीं।