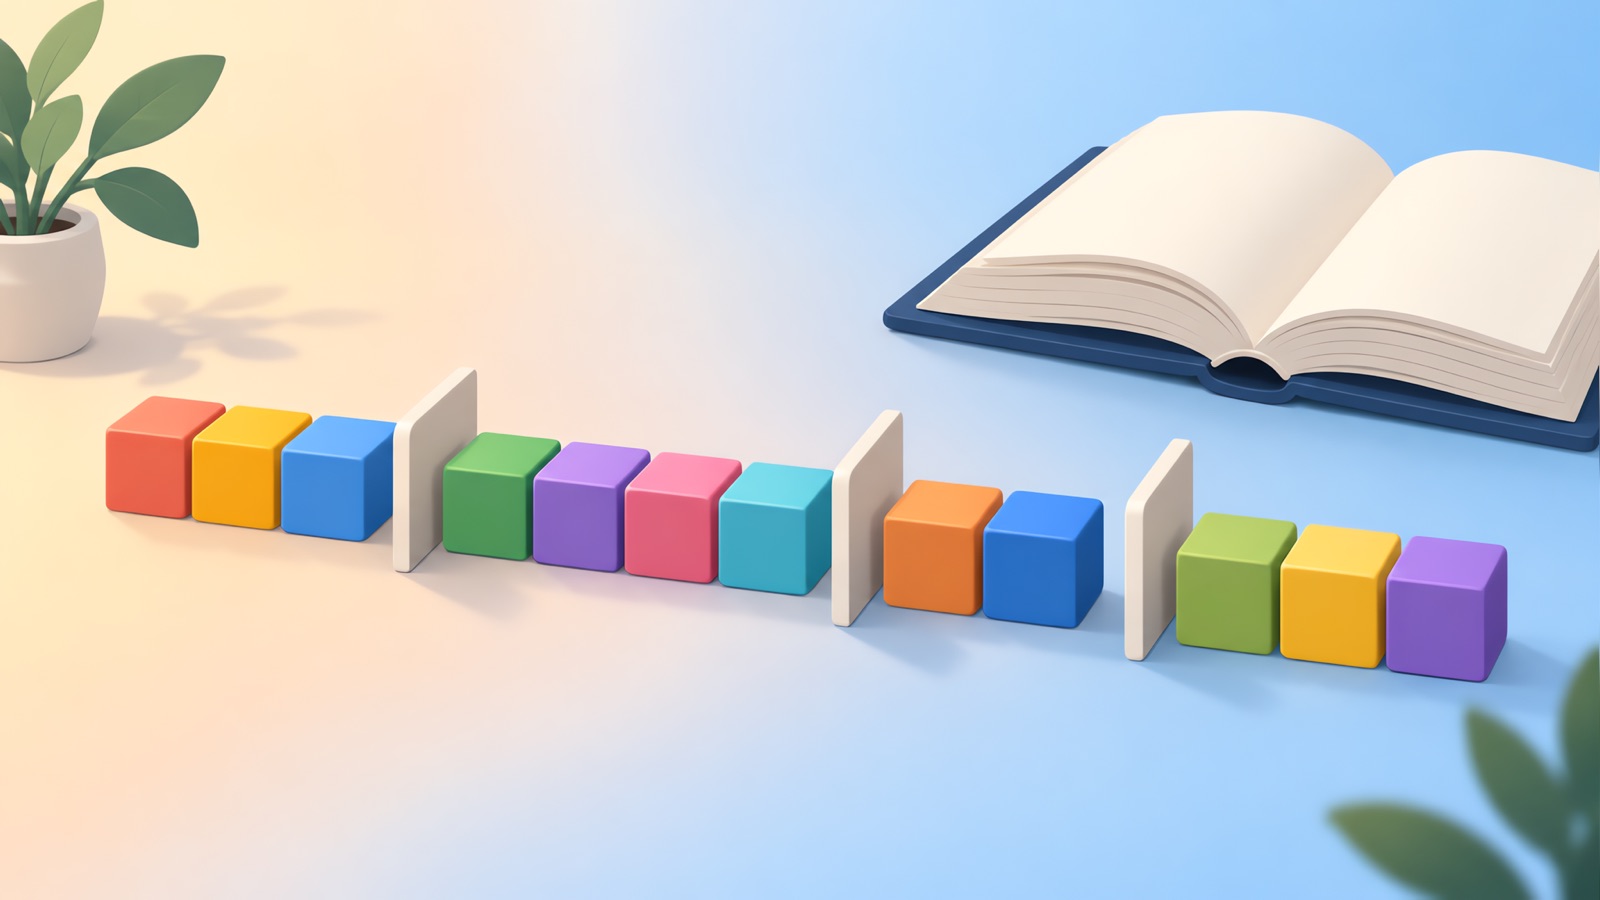
Word Break(LeetCode 139)问的是:一个字符串能否拆分成若干个都在字典中出现的单词。最清晰的解法是对前缀做动态规划:如果某个更短的可拆分前缀后面接一个字典中的单词,那么这个前缀就是可拆分的。只要限制回看范围,时间复杂度就是 O(n × L),其中 L 是最长单词的长度。
问题
给定一个字符串 s 和一个单词列表 wordDict,如果 s 能拆分成一个或多个字典中的单词,返回 true。同一个单词可以重复使用任意多次。
| 输入 | 输出 | 原因 |
|---|---|---|
| s = "leetcode",["leet","code"] | true | leet + code |
| s = "applepenapple",["apple","pen"] | true | apple + pen + apple |
| s = "catsandog",["cats","dog","sand","and","cat"] | false | 没有任何拆分能覆盖最后的字母 |
可以问面试官的问题:字典里会有重复单词吗?字典可能为空吗?字符串保证非空吗?(去看题目页面上的约束条件。)
暴力解法
尝试每一个能匹配字符串开头的首单词,然后对剩余部分递归。对于像 "aaaaaaaaaab" 这样的字符串,配合单词 a、aa、aaa,递归会反复访问相同的后缀,所以时间是指数级的。解决办法是记住每个起始位置的答案。
方法一:自顶向下 + 记忆化
定义 can(start) 表示从 start 开始的后缀能否被拆分。把结果缓存起来。
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
n 个起始位置每个只求解一次,每个最多尝试 n 个结束位置,涉及一次切片和一次集合查找。也就是 O(n²) 次查找,如果算上构造每个切片的开销,就是 O(n³) 的字符操作。空间是 O(n),用于缓存和递归。
方法二:自底向上动态规划
设 dp[i] 表示前 i 个字符能否被拆分。dp[0] 为 true,因为空前缀不需要任何单词。对每个结束位置,找一个起始位置,使得 dp[start] 为 true 且 s[start:end] 是一个单词。
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
把 start 限制在最后 max_len 个位置很关键。字典中的单词不可能比最长单词还长,所以检查更长的切片没有意义。这样内层循环最多 L 步,整体就是 O(n × L) 次查找。
追踪
对于 s = "leetcode" 配合 ["leet","code"]:dp[0] 为 true。dp[4] 变为 true,因为 dp[0] 为 true 且 "leet" 是一个单词。dp[8] 变为 true,因为 dp[4] 为 true 且 "code" 是一个单词。答案是 dp[8],为 true。
常见错误
- 忘了单词可以重复使用。
- 只要某个前缀是单词就返回 true。必须覆盖整个字符串。
- 构造每个切片时没有加 max_len 限制,虽然正确,但在长字符串上很慢。
- 很晚才把字典转成集合,或者根本没转,导致每次查找都要遍历列表。
需要测试的边界情况
| 输入 | 预期 |
|---|---|
| 字符串本身就是一个单词 | true |
| 一个单词是另一个的前缀("a"、"aa") | 由 DP 处理,而不是贪心匹配 |
| 字符串含有任何单词都不包含的字母 | false |
| 贪心会失败("cars" 配合 "car"、"ca"、"rs") | true,取 ca + rs |
面试中怎么讲
- 说出暴力解法,以及它为什么重复计算。
- 说明子问题:长度为 i 的前缀能否被构造出来?
- 用文字写出递推关系,然后写自底向上的代码。
- 提到 max_len 限制并给出复杂度。
- 如果面试官偏好递归,提供记忆化版本。
发布前,我把上面两个版本和暴力搜索在 20,000 个随机小输入上做了对比测试,外加表格里的三个例子。这种快速随机验证是练习时的好习惯。
相关练习
复杂度术语见我们的 Big O 速查表,接下来练什么见 LeetCode Blind 75 清单,怎么练习见编程面试助手指南。
写代码时把思路大声讲出来。文字记录能看出你是否在动手前说出了关键观察。在任何实时评估中,都要遵守雇主关于 AI 工具的规定。
使用 YesToTheOffer 练习编程面试
大声讲解你的思路,然后事后回顾你的文字记录。30 分钟免费,无需订阅。