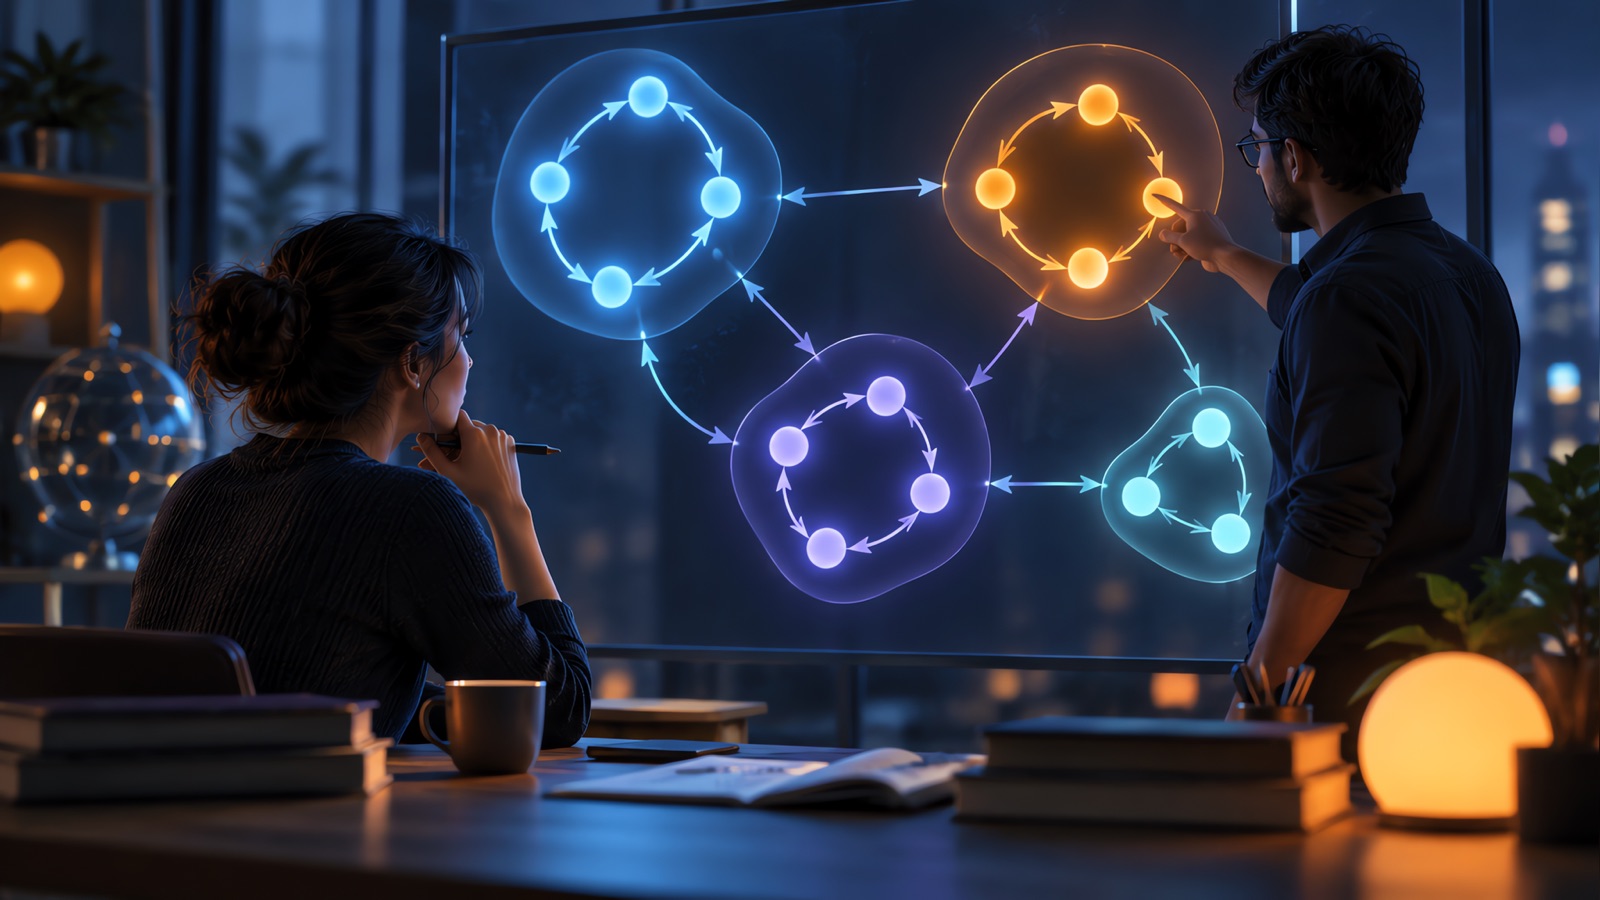
Kosaraju 算法用于找出有向图的强连通分量(SCC)。所谓 SCC,就是一组顶点,其中任意一个顶点都能到达其他所有顶点。该算法执行两次深度优先搜索:第一次记录顶点的完成顺序,第二次在将所有边反向后的图上、按完成顺序的逆序处理顶点。第二次搜索得到的每一棵树就是一个 SCC。算法的时间复杂度为 O(V + E)。
如果把每个 SCC 压缩成一个节点,剩下的就是一个无环有向图。正因如此,SCC 才会出现在依赖分析、死锁检测、2-SAT,以及任何需要先消除环的问题中。
两趟遍历,逐步拆解
- 对整个图运行 DFS。当一个顶点完成时(它的所有出边邻居都已处理完),把它压入一个列表。
- 将每条边反向,得到转置图。
- 从完成列表的末尾向前遍历。对于每个尚未访问的顶点,在转置图上运行 DFS。该搜索能到达的所有顶点构成一个 SCC。
两个循环都必须从每个未访问的顶点开始,而不能只从顶点 0 开始,因为图可能不是连通的。
一个完整示例
取 8 个顶点和以下边:
0 → 1, 1 → 2, 2 → 0      (cycle A: 0, 1, 2)
2 → 3
3 → 4, 4 → 5, 5 → 3      (cycle B: 3, 4, 5)
6 → 5
6 → 7, 7 → 6             (cycle C: 6, 7)
SCC 应该是 2、5 和 7。
第一趟
从 0 开始 DFS,沿着 0 → 1 → 2 → 3 → 4 → 5 前进。顶点 5 没有新的地方可去,所以它最先完成,然后是 4,再是 3。回到 2 时已无路可走,于是 2、1、0 依次完成。顶点 6 尚未访问,从它开始:5 已经完成,于是走到 7,7 完成,然后 6 完成。完成顺序为:
5, 4, 3, 2, 1, 0, 7, 6
第二趟
将每条边反向,从该列表末尾开始处理顶点:先是 6。在反向图中,6 只能到达 7,所以 7 是第一个 SCC。下一个未访问的是 0,在反向图中它能到达 2 和 1,得到 2。边 2 → 3 现在指向 3 → 2,但 2 已被分配,所以搜索在此停止。最后,3 能到达 5 和 4,得到 5。
为什么这样是对的
想象由 SCC 构成的图(每个分量压缩为一个节点),它是无环的。在第一趟中,最后完成的顶点总是属于一个“源”分量,即没有来自其他未分配分量的边指向它。将边反向会把该源变成汇,因此从那里开始的 DFS 无法离开它自己的分量。一旦该分量被移除,同样的论证适用于下一个分量。
在面试中,通常这就是所期望的证明深度:完成顺序选出一个安全的起始分量,而反向边则防止第二次搜索泄漏到其他分量中。
Python 实现
这个版本使用迭代式 DFS,因此在深图上不会触发 Python 的递归限制。
from collections import defaultdict

def kosaraju(n, edges):
    graph = defaultdict(list)
    reverse = defaultdict(list)
    for u, v in edges:
        graph[u].append(v)
        reverse[v].append(u)

    # Pass 1: record vertices in the order they finish (iterative DFS)
    visited = [False] * n
    order = []
    for start in range(n):
        if visited[start]:
            continue
        visited[start] = True
        stack = [(start, iter(graph[start]))]
        while stack:
            node, neighbors = stack[-1]
            for nxt in neighbors:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append((nxt, iter(graph[nxt])))
                    break
            else:
                stack.pop()
                order.append(node)

    # Pass 2: DFS on the reversed graph, latest finish time first
    visited = [False] * n
    components = []
    for start in reversed(order):
        if visited[start]:
            continue
        visited[start] = True
        component = []
        stack = [start]
        while stack:
            node = stack.pop()
            component.append(node)
            for nxt in reverse[node]:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append(nxt)
        components.append(component)
    return components


edges = [(0, 1), (1, 2), (2, 0), (2, 3), (3, 4), (4, 5), (5, 3), (6, 5), (6, 7), (7, 6)]
print(kosaraju(8, edges))  # [[6, 7], [0, 2, 1], [3, 5, 4]]
每个分量内部顶点的顺序取决于遍历方式,所以在测试中应将分量作为集合来比较。我们在 2,000 个随机图上用暴力可达性检查验证了这个实现。
复杂度
| 步骤 | 时间 |
|---|---|
| 第一次 DFS | O(V + E) |
| 构建反向图 | O(V + E) |
| 第二次 DFS | O(V + E) |
| 总计 | O(V + E) |
空间为 O(V + E),用于两个邻接表,外加 O(V) 用于 visited 数组、完成顺序和栈。
会导致出错的常见错误
最常见的 bug 是在 DFS 首次到达顶点时记录它,而不是在它完成时记录。其他错误包括:忘记为第二趟反转完成顺序、在原始图而非反向图上运行第二趟、两趟之间没有清空 visited 数组,以及只从顶点 0 开始导致不连通的部分被跳过。递归 DFS 在长链上还可能栈溢出,这就是上面代码采用迭代式的原因。
好的测试用例:单个顶点、带自环的顶点、一个大环、单向链(每个顶点都是自己的 SCC)、由一条边连接的两个环,以及不连通的图。
Kosaraju 与 Tarjan 对比
两者都在 O(V + E) 时间内运行。Kosaraju 需要两趟并构建反向图,这使它更容易解释、也更容易写对。Tarjan 算法只需一趟且不需要反向图,但要在栈上跟踪发现索引和 low-link 值,需要维护的状态更多。在面试中,用你能正确实现并解释清楚的那个。如果面试官要求单趟完成,那就是在暗示用 Tarjan。
练习图问题
在写代码之前,先手动追踪一遍上面的示例;大多数 bug 都会表现为完成顺序错误。相关指南:Floyd–Warshall 用于全源最短路径,Bellman–Ford 用于含负权边的图,以及我们的 Big O 速查表。如果你在编程练习中使用 YesToTheOffer,它的截图编程帮助可以检查你的思路,而会话记录能显示你是否清晰地解释了推理过程。
通过反馈练习编程面试
截图编程帮助和练习会话的转录。30 分钟免费。