合并 k 个排序链表(LeetCode 23)要求你把 k 个已排序的链表合并成一个有序链表。它之所以经典,是因为暴力解法显而易见,而真正有意思的地方在于如何在两种更优解法之间做选择:最小堆或分治法。两者的时间复杂度都是 O(N log k),其中 N 是节点总数。
问题描述
给定一个包含 k 个链表的数组,每个链表都按升序排列,将它们合并成一个有序链表并返回。
示例:[[1,4,5],[1,3,4],[2,6]] 合并后变为 [1,1,2,3,4,4,5,6]。
可以向面试官提的问题:
- 数组可能为空吗?或者包含空链表吗?(都可能,两种都要处理。)
- 我应该复用已有节点还是创建新节点?(复用即可,还能省内存。)
- 可能存在重复值吗?(可能,所以如果有必要,要保持合并的稳定性。)
暴力解法
把所有值收集到一个数组里,排序,然后重新构建链表。时间复杂度 O(N log N),空间复杂度 O(N)。它能跑通,但忽略了每个链表本身已经有序这一事实,所以很少被当作最终答案接受。
解法一:最小堆
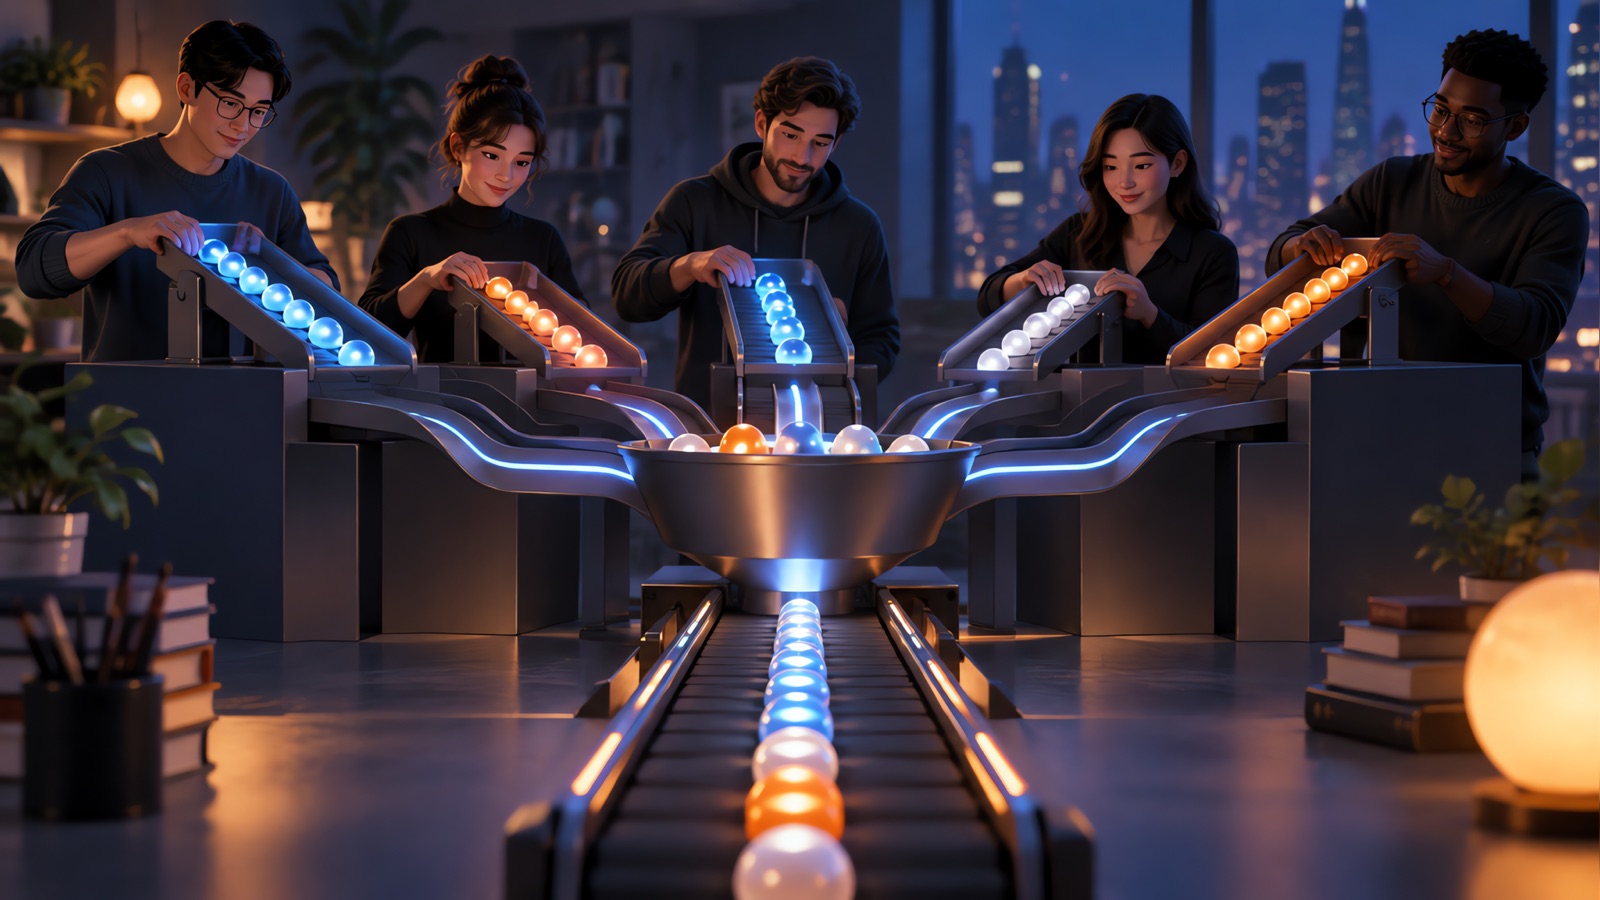
为每个链表维护一个指针。输出中的下一个节点永远是当前各链表头节点中最小的那个,所以把各个头节点放进一个最小堆里。
- 把每个非空链表的头节点压入堆中。
- 弹出最小的节点,追加到结果中,如果它有下一个节点,就把下一个节点压入堆中。
- 重复直到堆为空。
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
索引 i 是用来打破平局的。没有它的话,两个值相等的条目会让 Python 去比较 ListNode 对象,从而抛出 TypeError。
复杂度:N 个节点每个进堆一次、出堆一次,每次操作耗时 O(log k),所以总时间为 O(N log k)。堆中最多同时存放 k 个节点,所以额外空间为 O(k)。
解法二:分治法
合并两个有序链表很简单,耗时 O(n)。把链表两两合并,再把结果两两合并,依此类推,就像淘汰赛一样。
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
复杂度:大约有 log k 轮,每轮会遍历全部 N 个节点一次,所以时间为 O(N log k)。循环版本除了存放各链表头节点的数组外,只需要 O(1) 的额外空间。
为什么不逐个合并?
先把链表 1 和链表 2 合并,再把结果和链表 3 合并,依此类推,看起来很自然,但代价更高。第一个链表会被复制经过 k 次合并。如果每个链表有 n 个节点,总工作量大约是 n × (1 + 2 + ... + k),也就是 O(n k²)。两两配对能让各链表规模保持均衡,所以每个节点大约只被处理 log k 次。
两种解法对比
| 最小堆 | 分治法 | |
|---|---|---|
| 时间 | O(N log k) | O(N log k) |
| 额外空间 | O(k) | 循环版本为 O(1) |
| 代码 | 简短,需要打破平局的处理 | 复用 merge_two |
| 适用场景 | 链表以流的形式到达,或你只需要前几个结果 | 所有链表都在内存中 |
如果面试官说链表太大放不进内存、会以流的形式到达,堆解法可以自然扩展,因为它只需要每个流的当前头节点。
需要测试的边界情况
| 输入 | 预期结果 |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| 一个非空链表 | 该链表本身 |
| 跨链表的重复值 | 全部保留,且保持顺序 |
| 负数 | 同样处理 |
| 长度差异极大 | 能处理,因为剩余的链表会直接接在末尾 |
面试中如何讲解
- 说出暴力解法,并说明它为什么浪费。
- 说出关键观察:下一个输出节点是当前头节点中最小的那个。
- 选择堆解法,写出来,并提到打破平局的处理。
- 说明复杂度:时间 O(N log k),空间 O(k)。
- 提出分治法作为 O(1) 空间的替代方案。
- 用空输入和含重复值的输入做测试。
发布前,我用 3,000 个随机输入(包括空链表)对上面两个版本做了基于排序的校验。练习时做这样的快速随机校验是个好习惯。
相关练习
如果这道题对你来说太简单,可以先试试合并两个有序链表,然后做排序链表和从数据流中找中位数,它们用的是相同的思路。复杂度术语可以看我们的 Big O 速查表,动态规划可以看最长公共子串指南,练习方法可以看编程面试助手指南。
写代码时把思路大声讲出来。一份模拟面试记录能看出你在动手写之前有没有讲清关键观察。在任何实时测评中,都要遵守雇主关于 AI 工具的规定。
使用YesToTheOffer练习编程面试
进行模拟编程面试,大声解释你的方法,然后回顾你的记录。30分钟免费,无需订阅。