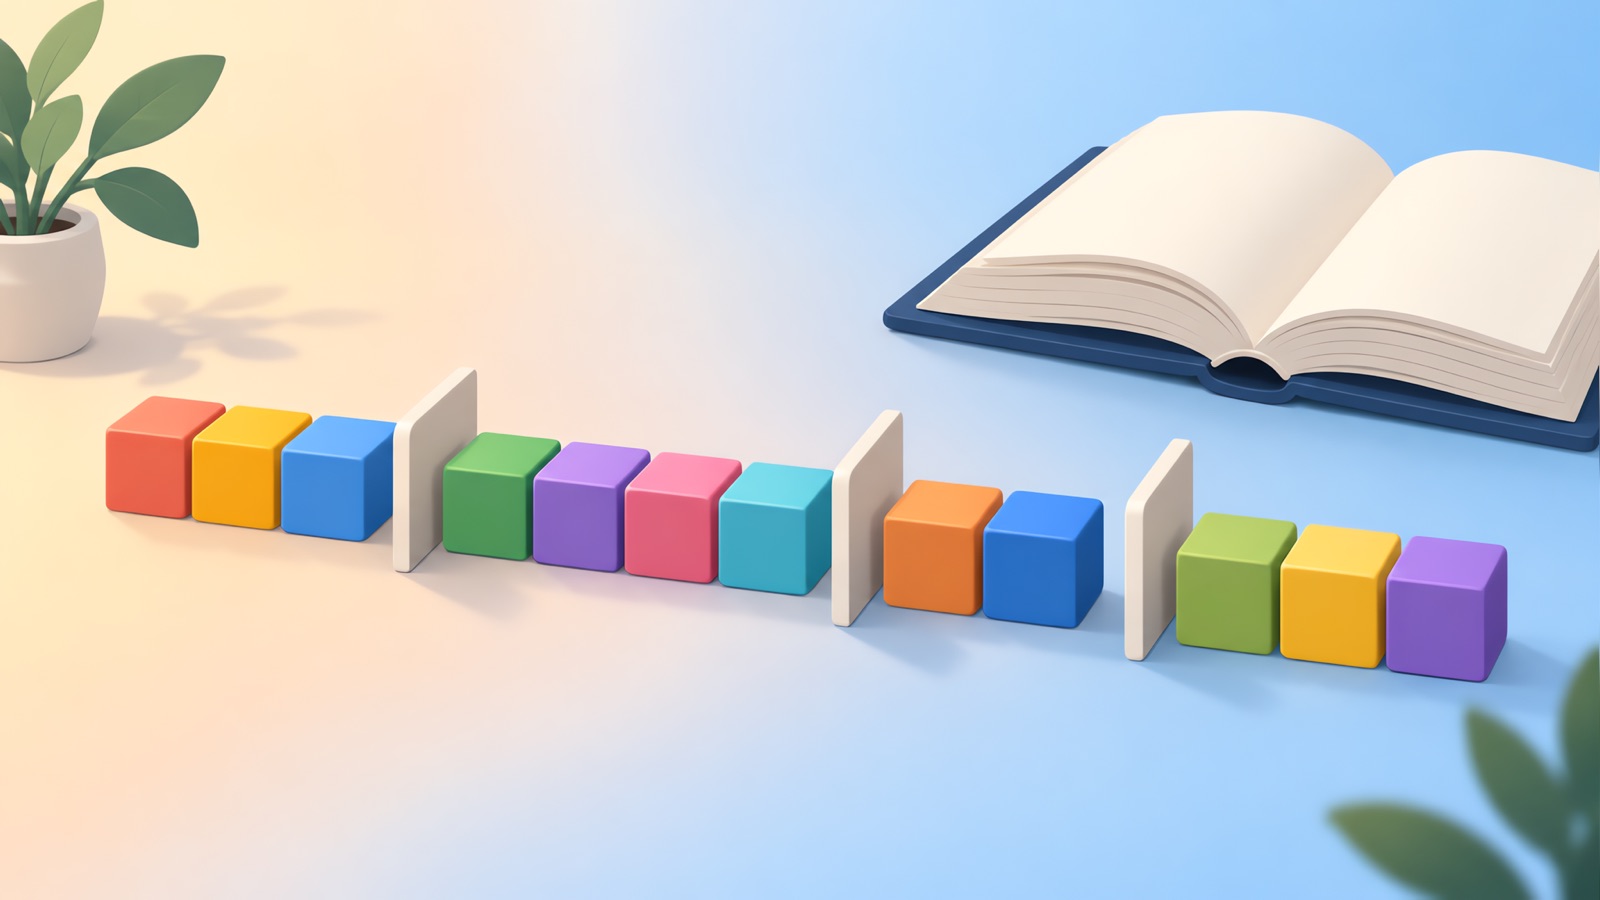
Word Break (LeetCode 139) पूछता है कि क्या किसी स्ट्रिंग को ऐसे शब्दों के क्रम में तोड़ा जा सकता है जो सभी किसी डिक्शनरी में मौजूद हों। साफ़-सुथरा जवाब है प्रीफ़िक्स पर डायनामिक प्रोग्रामिंग: कोई प्रीफ़िक्स तभी बन सकता है जब कोई छोटा, बनने योग्य प्रीफ़िक्स हो और उसके बाद कोई डिक्शनरी शब्द आए। यह O(n times L) में चलता है, जहाँ L सबसे लंबा शब्द है, बशर्ते आप यह सीमित कर दें कि कितना पीछे देखना है।
समस्या
एक स्ट्रिंग s और शब्दों की एक सूची wordDict दी गई है, तो true लौटाएँ अगर s को एक या अधिक डिक्शनरी शब्दों में तोड़ा जा सकता है। किसी शब्द का दोबारा जितनी बार चाहें उपयोग किया जा सकता है।
| Input | Output | क्यों |
|---|---|---|
| s = "leetcode", ["leet","code"] | true | leet + code |
| s = "applepenapple", ["apple","pen"] | true | apple + pen + apple |
| s = "catsandog", ["cats","dog","sand","and","cat"] | false | कोई भी विभाजन आख़िरी अक्षरों को कवर नहीं करता |
इंटरव्यूअर से पूछने वाले सवाल: क्या डिक्शनरी में डुप्लिकेट हो सकते हैं, क्या यह खाली हो सकती है, और क्या स्ट्रिंग के खाली न होने की गारंटी है? (समस्या पेज पर दी गई constraints देखें।)
ब्रूट फ़ोर्स
हर उस पहले शब्द को आज़माएँ जो स्ट्रिंग की शुरुआत से मेल खाता हो, फिर बाक़ी हिस्से पर रिकर्शन करें। "aaaaaaaaaab" जैसी स्ट्रिंग और a, aa, aaa शब्दों के साथ, रिकर्शन एक ही सफ़िक्स को कई बार दोहराता है, इसलिए समय एक्सपोनेंशियल हो जाता है। इसे ठीक करने का तरीक़ा है हर शुरुआती पोज़िशन का जवाब याद रखना।
तरीक़ा 1: मेमोइज़ेशन के साथ टॉप-डाउन
can(start) को इस रूप में परिभाषित करें कि start से शुरू होने वाले सफ़िक्स को तोड़ा जा सकता है या नहीं। नतीजे को कैश करें।
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
n शुरुआती पोज़िशन में से हर एक को एक बार हल किया जाता है, और हर एक n तक की अंत पोज़िशन आज़माती है, एक स्लाइस और एक सेट लुकअप के साथ। यह O(n squared) लुकअप हैं, या O(n cubed) अक्षर-कार्य अगर आप हर स्लाइस बनाने की लागत गिनें। स्पेस कैश और रिकर्शन के लिए O(n) है।
तरीक़ा 2: बॉटम-अप डायनामिक प्रोग्रामिंग
मान लें dp[i] true है अगर पहले i अक्षरों को तोड़ा जा सकता है। dp[0] true है, क्योंकि खाली प्रीफ़िक्स को किसी शब्द की ज़रूरत नहीं। हर अंत पोज़िशन के लिए, ऐसी शुरुआत खोजें जहाँ dp[start] true हो और s[start:end] एक शब्द हो।
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
start को आख़िरी max_len पोज़िशन तक सीमित करना मायने रखता है। कोई डिक्शनरी शब्द सबसे लंबे शब्द से बड़ा नहीं हो सकता, इसलिए लंबे स्लाइस जाँचने का कोई फ़ायदा नहीं। यह अंदरूनी लूप को अधिकतम L स्टेप्स का बना देता है, और पूरी चीज़ को O(n times L) लुकअप की।
ट्रेस
s = "leetcode" के साथ ["leet","code"]: dp[0] true है। dp[4] true हो जाता है क्योंकि dp[0] true है और "leet" एक शब्द है। dp[8] true हो जाता है क्योंकि dp[4] true है और "code" एक शब्द है। जवाब dp[8] है, जो true है।
आम गलतियाँ
- यह भूल जाना कि शब्दों का दोबारा उपयोग किया जा सकता है।
- जैसे ही कोई प्रीफ़िक्स एक शब्द हो, true लौटा देना। पूरी स्ट्रिंग को कवर करना ज़रूरी है।
- max_len सीमा के बिना हर स्लाइस बनाना, जो सही है लेकिन लंबी स्ट्रिंग पर धीमा है।
- डिक्शनरी को सेट में देर से बदलना, या बिल्कुल न बदलना, जिससे हर लुकअप एक सूची को स्कैन करता है।
टेस्ट करने योग्य एज केस
| Input | अपेक्षित |
|---|---|
| स्ट्रिंग ख़ुद एक शब्द है | true |
| एक शब्द दूसरे का प्रीफ़िक्स है ("a", "aa") | DP से संभाला जाता है, ग्रीडी मैचिंग से नहीं |
| स्ट्रिंग में ऐसा अक्षर है जो किसी शब्द में नहीं है | false |
| ग्रीडी फ़ेल होता है ("cars" के साथ "car", "ca", "rs") | true, ca + rs लेकर |
इंटरव्यू में इसे कैसे समझाएँ
- ब्रूट फ़ोर्स बताएँ और यह कि यह काम क्यों दोहराता है।
- सबप्रॉब्लम बताएँ: क्या लंबाई i का प्रीफ़िक्स बनाया जा सकता है?
- रिकरेंस को शब्दों में लिखें, फिर बॉटम-अप वर्शन कोड करें।
- max_len सीमा का ज़िक्र करें और कॉम्प्लेक्सिटी बताएँ।
- अगर इंटरव्यूअर रिकर्शन पसंद करता है तो मेमोइज़्ड वर्शन पेश करें।
मैंने पब्लिश करने से पहले ऊपर दिए दोनों वर्शन को 20,000 रैंडम छोटे इनपुट पर ब्रूट-फ़ोर्स सर्च के ख़िलाफ़ टेस्ट किया, साथ ही टेबल में दिए तीन उदाहरण भी। ऐसा तेज़ रैंडम चेक करना अभ्यास के दौरान एक अच्छी आदत है।
संबंधित अभ्यास
कॉम्प्लेक्सिटी शब्दों के लिए हमारी Big O cheat sheet देखें, आगे क्या अभ्यास करें इसके लिए LeetCode Blind 75 list, और अभ्यास कैसे करें इसके लिए coding interview assistant guide देखें।
कोड करते समय अपना तरीक़ा ज़ोर से बोलकर समझाएँ। एक ट्रांसक्रिप्ट दिखाता है कि आपने लिखने से पहले मुख्य अवलोकन बताया या नहीं। किसी भी लाइव असेसमेंट में AI टूल्स पर नियोक्ता के नियमों का पालन करें।
YesToTheOffer के साथ कोडिंग साक्षात्कार का अभ्यास करें
अपने दृष्टिकोण को जोर से समझाएं, फिर बाद में अपने ट्रांसक्रिप्ट की समीक्षा करें। 30 मुफ्त मिनट, कोई सदस्यता नहीं।