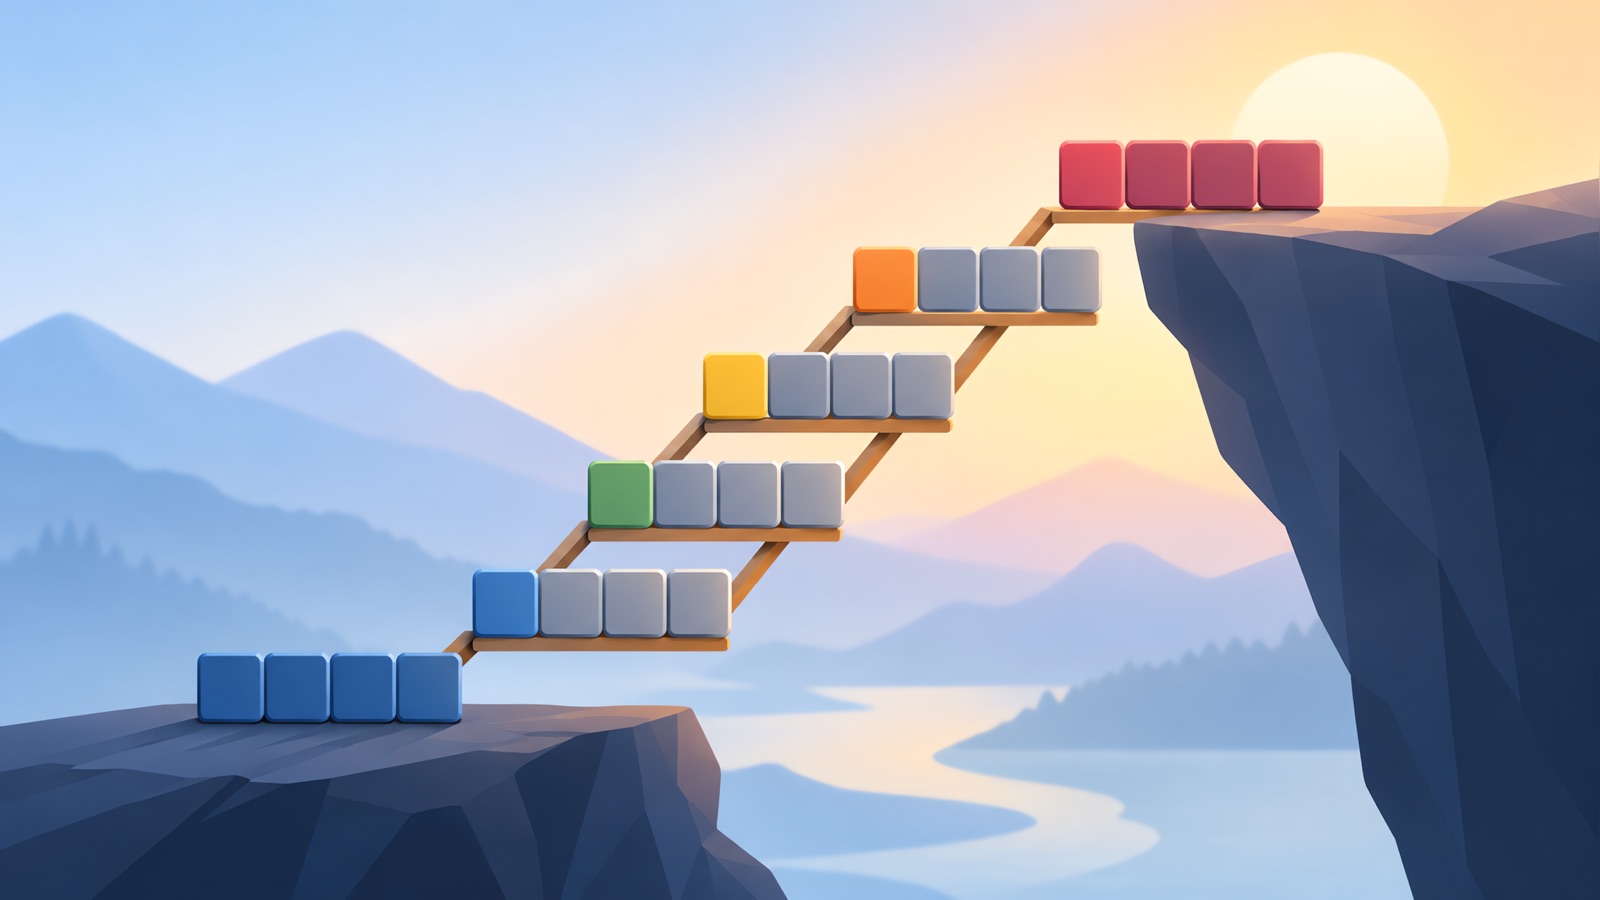
Word Ladder (LeetCode 127) में एक शब्द से दूसरे शब्द तक की सबसे छोटी श्रृंखला की लंबाई पूछी जाती है, जिसमें एक बार में एक अक्षर बदलता है और हर कदम दी गई सूची में होना चाहिए। बराबर कदमों वाला सबसे छोटा रास्ता यानी breadth-first search। इसे तेज़ बनाने वाली चाल यह है कि शब्दों को h*t जैसे wildcard patterns के हिसाब से समूहों में बाँट दिया जाए, ताकि हर जोड़ी की तुलना न करनी पड़े।
समस्या
आपको beginWord, endWord, और शब्दों की एक सूची दी गई है। beginWord से endWord तक की सबसे छोटी रूपांतरण श्रृंखला में कुल कितने शब्द आते हैं, यह लौटाना है—दोनों सिरों सहित। हर कदम में ठीक एक अक्षर बदलता है, और जिस शब्द पर आप जाते हैं वह सूची में होना चाहिए। अगर ऐसी कोई श्रृंखला न हो तो 0 लौटाएँ।
| Input | Output | क्यों |
|---|---|---|
| hit से cog, सूची hot dot dog lot log cog | 5 | hit, hot, dot, dog, cog |
| hit से cog, सूची hot dot dog lot log | 0 | cog सूची में नहीं है |
breadth-first search क्यों
हर शब्द को एक node मानिए, और जिन दो शब्दों में एक अक्षर का फ़र्क़ है उनके बीच edge। हर edge की लागत एक कदम है, इसलिए सबसे छोटी श्रृंखला unweighted graph में सबसे छोटा रास्ता है, और breadth-first search उसे तभी पकड़ लेता है जब वह पहली बार अंतिम शब्द तक पहुँचता है।
brute force से edge बनाना
हर जोड़ी की तुलना करके देखना कि उनमें एक अक्षर का फ़र्क़ है या नहीं, N शब्दों और लंबाई L के लिए O(N squared times L) लेता है। हज़ारों शब्दों के साथ यह धीमा है। बेहतर तरीका: patterns से पड़ोसी शब्द बनाइए।
तरीका: wildcard patterns
बारी-बारी से हर अक्षर को * से बदल दीजिए। hot बन जाता है *ot, h*t, और ho*। दो शब्द ठीक तब पड़ोसी होते हैं जब उनका कोई pattern साझा हो। pattern से उन शब्दों तक का map बनाइए जो उसमें फ़िट होते हैं, फिर उसी की मदद से search चलाइए।
from collections import deque, defaultdict

def ladder_length(begin_word, end_word, word_list):
    words = set(word_list)
    if end_word not in words:
        return 0
    patterns = defaultdict(list)
    for w in words | {begin_word}:
        for i in range(len(w)):
            patterns[w[:i] + "*" + w[i + 1:]].append(w)
    queue = deque([(begin_word, 1)])
    seen = {begin_word}
    while queue:
        word, steps = queue.popleft()
        if word == end_word:
            return steps
        for i in range(len(word)):
            key = word[:i] + "*" + word[i + 1:]
            for nxt in patterns[key]:
                if nxt not in seen:
                    seen.add(nxt)
                    queue.append((nxt, steps + 1))
            patterns[key] = []
    return 0
दो बातें मायने रखती हैं। begin word को pattern map में तब भी जोड़ा जाता है जब वह सूची में न हो, क्योंकि शुरुआत उसी से होती है। और किसी pattern के शब्द visit हो जाने के बाद patterns[key] = [] उसे खाली कर देता है, ताकि वही समूह उस pattern को साझा करने वाले हर दूसरे शब्द से दोबारा न स्कैन हो। इससे कुल काम patterns की संख्या के हिसाब से linear रहता है।
complexity
patterns बनाने में O(N times L) लगता है, और हर pattern string बनाने में O(L), यानी कुल मिलाकर लगभग O(N times L squared)। search हर शब्द को एक बार और हर pattern समूह को एक बार छूता है, इसलिए bound वही रहता है। pattern map के लिए space O(N times L squared) है, क्योंकि हर शब्द L लंबाई की L keys के नीचे स्टोर होता है।
और तेज़: bidirectional search
एक search begin word से और एक end word से चलाइए, और हमेशा छोटे frontier को expand कीजिए। दोनों बीच में मिल जाते हैं, इसलिए हर तरफ़ आधी गहराई ही search होती है। अगर interviewer पूछे कि इसे तेज़ कैसे करें, तो यह बताने लायक है, और इसमें ज़्यादातर interviews की अपेक्षा से ज़्यादा code लिखना पड़ता है।
आम गलतियाँ
- बदलावों की संख्या लौटा देना, शब्दों की संख्या की जगह। श्रृंखला में beginWord भी शामिल है, इसलिए उदाहरण में 5 आता है, 4 नहीं।
- search से पहले यह जाँच न करना कि endWord सूची में है या नहीं।
- pairwise तुलना से पड़ोसी बनाना और time out हो जाना।
- search को शब्दों पर दोबारा जाने देना, जिससे loop बनता है या वह धीमा हो जाता है।
- DFS इस्तेमाल करना, जो रास्ता तो ढूँढ लेता है पर सबसे छोटा नहीं।
जिन edge cases को test करें
| Input | अपेक्षित |
|---|---|
| endWord सूची में नहीं है | 0 |
| एक अक्षर के शब्द | सूची का कोई भी दूसरा शब्द एक कदम दूर है |
| अंतिम शब्द begin word से एक कदम दूर | 2 |
| ऐसे शब्द जिनका कोई जोड़ नहीं | 0 |
interview में इसे कैसे समझाएँ
- इसे graph के रूप में फिर से परिभाषित कीजिए और बताइए कि breadth-first search सबसे छोटा रास्ता क्यों ढूँढता है।
- कहिए कि pairwise तुलना बहुत धीमी है, और wildcard patterns पेश कीजिए।
- pattern map, queue, और visited set लिखिए।
- बताइए कि आप शब्द गिनते हैं, बदलाव नहीं, और पहला उदाहरण दिखाइए।
- complexity बताइए और bidirectional search का ज़िक्र कीजिए।
मैंने ऊपर दिया code publish करने से पहले 20,000 random छोटी word lists पर एक सादे pairwise breadth-first search के ख़िलाफ़ test किया, साथ ही table के दोनों उदाहरणों पर भी। अभ्यास करते समय ऐसा तेज़ random check करना अच्छी आदत है।
संबंधित अभ्यास
complexity की शब्दावली के लिए हमारी Big O cheat sheet देखिए, आगे क्या अभ्यास करें इसके लिए LeetCode Blind 75 list, और अभ्यास कैसे करें इसके लिए coding interview assistant guide।
code लिखते समय अपना तरीका बोलकर समझाइए। transcript से पता चलता है कि आपने लिखने से पहले मुख्य बात कही थी या नहीं। किसी भी live assessment में AI tools को लेकर employer के नियमों का पालन कीजिए।
YesToTheOffer के साथ कोडिंग साक्षात्कार का अभ्यास करें
अपने दृष्टिकोण को जोर से समझाएं, फिर बाद में अपने प्रतिलेख की समीक्षा करें। 30 मुफ्त मिनट, कोई सदस्यता नहीं।