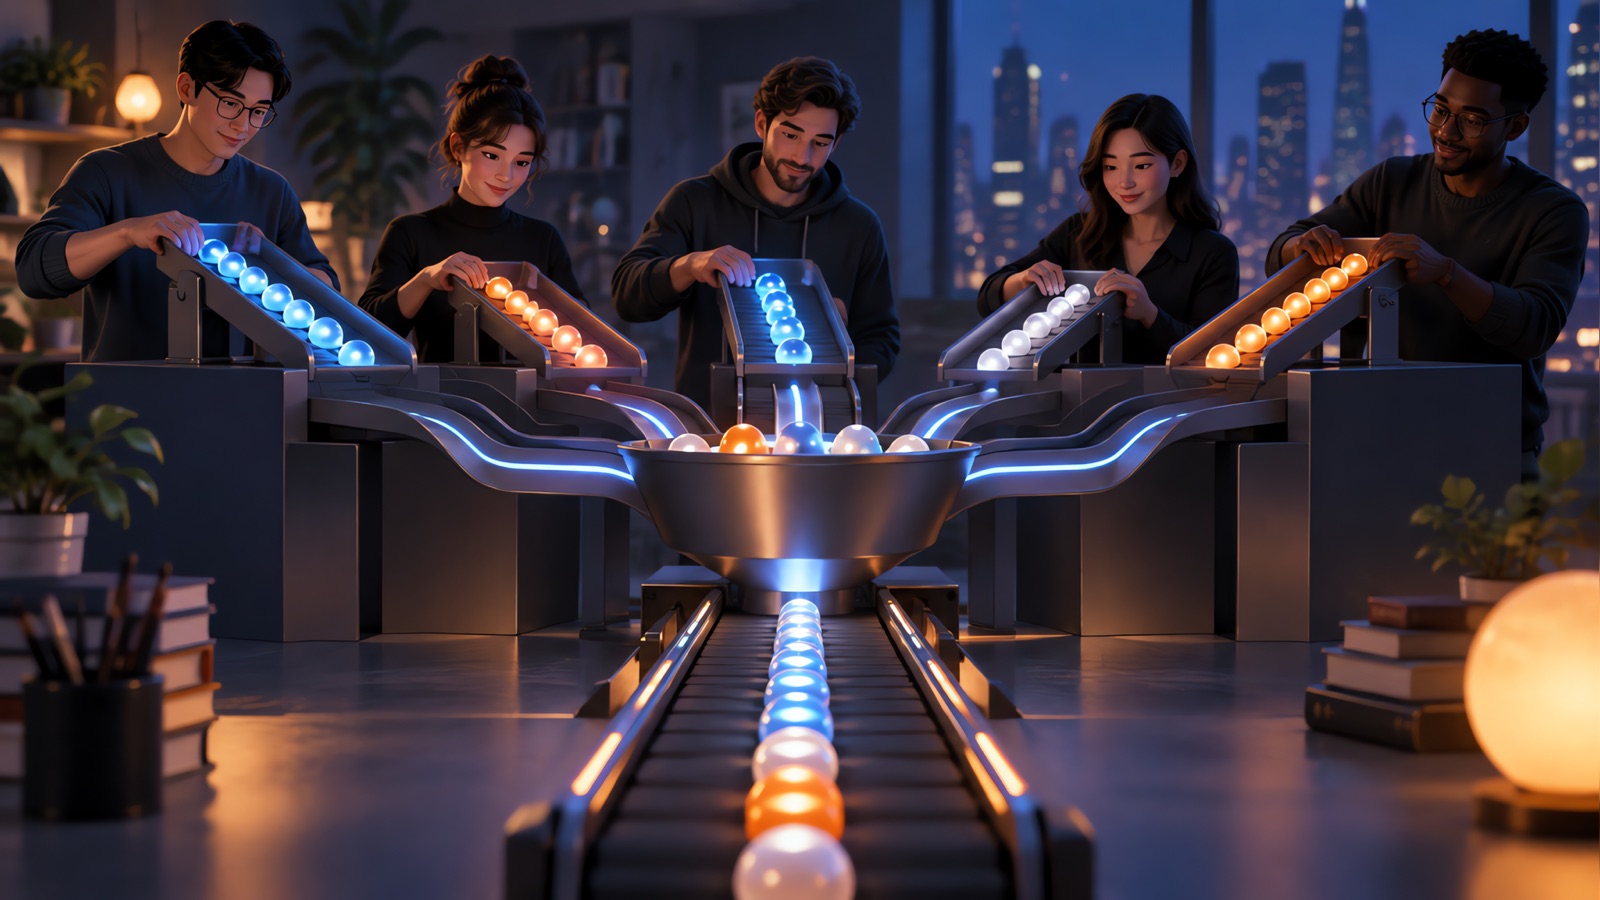
Объединение k отсортированных списков (LeetCode 23) — это задача о слиянии k отсортированных связных списков в один отсортированный список. Она популярна потому, что решение «в лоб» очевидно, а самое интересное — выбрать между двумя хорошими способами сделать лучше: min-heap или «разделяй и властвуй». Оба работают за O(N log k), где N — общее число узлов.
Задача
Дан массив из k связных списков, каждый отсортирован по возрастанию. Нужно объединить их в один отсортированный связный список и вернуть его.
Пример: [[1,4,5],[1,3,4],[2,6]] превращается в [1,1,2,3,4,4,5,6].
Вопросы, которые стоит задать интервьюеру:
- Массив может быть пустым или содержать пустые списки? (Да, нужно обработать оба случая.)
- Можно переиспользовать существующие узлы или создавать новые? (Переиспользовать можно и это экономит память.)
- Дубликаты значений возможны? (Да, так что сохраняйте стабильность слияния, если это важно.)
Решение «в лоб»
Соберите все значения в массив, отсортируйте его и постройте список заново. Время — O(N log N), память — O(N). Работает, но игнорирует то, что каждый список уже отсортирован, поэтому такое решение редко принимают как финальное.
Подход 1: min-heap
Держите по одному указателю на каждый список. Следующий узел в результате — всегда наименьший среди текущих голов, поэтому храните головы в min-heap.
- Положите в кучу голову каждого непустого списка.
- Извлеките наименьший, добавьте его в результат и положите в кучу его следующий узел, если он есть.
- Повторяйте, пока куча не опустеет.
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
Индекс i нужен для разрешения ничьих. Без него две записи с одинаковыми значениями заставили бы Python сравнивать объекты ListNode, что выбросило бы TypeError.
Сложность: каждый из N узлов попадает в кучу один раз и выходит из неё один раз, а каждая операция стоит O(log k), значит время — O(N log k). В куче не больше k узлов, поэтому дополнительная память — O(k).
Подход 2: разделяй и властвуй
Слить два отсортированных списка легко, это занимает O(n) времени. Объединяйте списки попарно, затем объединяйте результаты попарно и так далее, как в турнире.
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
Сложность: примерно log k раундов, и в каждом раунде все N узлов проходятся один раз, значит время — O(N log k). Итеративной версии нужно всего O(1) дополнительной памяти помимо массива голов.
Почему не сливать по одному?
Слить список 1 со списком 2, затем результат со списком 3 и так далее выглядит естественно, но стоит дороже. Первый список проходит через k слияний. Если в каждом списке n узлов, общая работа — примерно n x (1 + 2 + ... + k), то есть O(n k в квадрате). Попарное объединение сохраняет размеры сбалансированными, поэтому каждый узел затрагивается около log k раз.
Сравнение двух подходов
| Min-heap | Разделяй и властвуй | |
|---|---|---|
| Время | O(N log k) | O(N log k) |
| Доп. память | O(k) | O(1) в итеративной версии |
| Код | Короткий, нужен tiebreaker | Переиспользует merge_two |
| Хорош, когда | Списки приходят потоком или нужны только первые несколько результатов | Все списки есть в памяти |
Если интервьюер скажет, что списки слишком большие для памяти и приходят потоком, подход с кучей естественно расширяется, так как ему нужна только текущая голова каждого потока.
Краевые случаи для проверки
| Вход | Ожидание |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| Один непустой список | Этот список |
| Дубликаты значений в разных списках | Все сохранены, по порядку |
| Отрицательные числа | Обрабатываются так же |
| Очень разная длина | Обрабатывается, так как оставшийся список присоединяется в конце |
Как объяснить это на интервью
- Назовите решение «в лоб» и почему оно расточительно.
- Скажите ключевое наблюдение: следующий узел результата — наименьшая текущая голова.
- Выберите кучу, напишите её и упомяните tiebreaker.
- Назовите сложность: O(N log k) по времени и O(k) по памяти.
- Предложите «разделяй и властвуй» как альтернативу с O(1) памяти.
- Проверьте на пустом входе и на входе с дубликатами.
Перед публикацией я проверил обе версии выше против проверки на основе сортировки на 3 000 случайных входах, включая пустые списки. Такая быстрая случайная проверка — хорошая привычка во время практики.
Похожие задачи для практики
Если это было легко, попробуйте сначала Merge Two Sorted Lists, затем Sort List и Find Median from Data Stream — в них используются те же идеи. Смотрите нашу шпаргалку по Big O для терминов сложности, руководство по longest common substring для динамического программирования и руководство по ассистенту для собеседований по коду о том, как практиковаться.
Проговаривайте свой подход вслух, пока пишете код. Транскрипт mock-интервью показывает, объяснили ли вы ключевое наблюдение до того, как начали писать. Соблюдайте правила работодателя об AI-инструментах на любом живом ассессменте.
Практикуйте собеседования по программированию с YesToTheOffer
Пройдите mock-собеседование по программированию, объясните свой подход вслух и просмотрите расшифровку afterward. 30 бесплатных минут, без подписки.