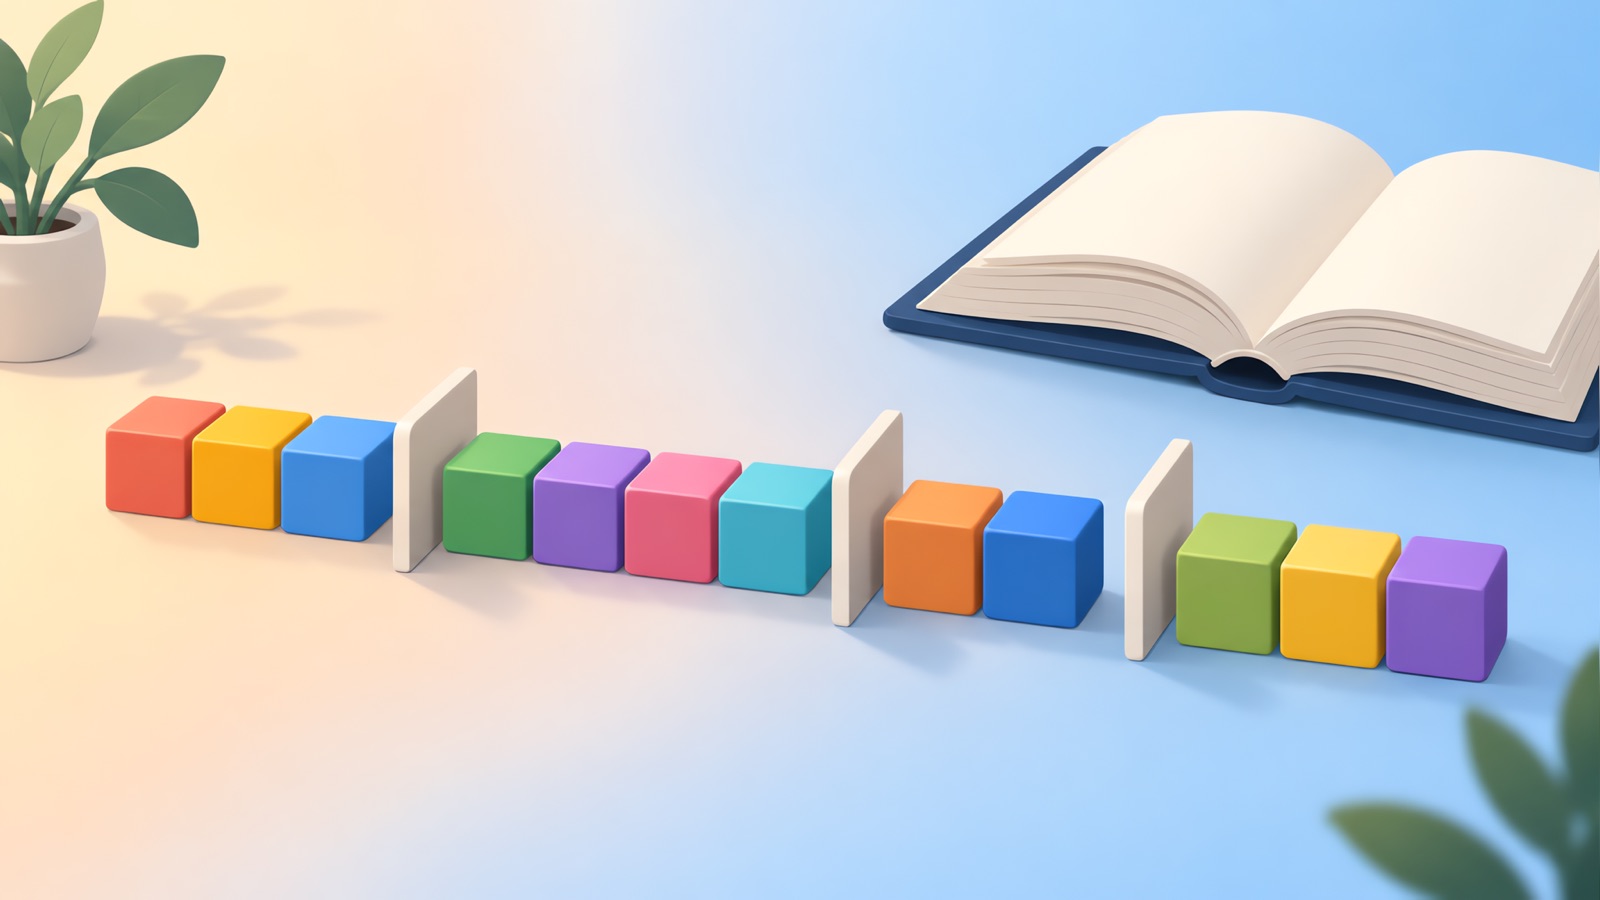
Word Break (LeetCode 139) vraagt of een string opgesplitst kan worden in een reeks woorden die allemaal in een woordenboek voorkomen. Het beste antwoord is dynamisch programmeren over prefixen: een prefix kan gevormd worden als een kortere opbouwbare prefix gevolgd wordt door een woordenboekwoord. Het algoritme draait in O(n keer L), waarbij L het langste woord is, zodra je beperkt hoe ver je terugkijkt.
Het probleem
Gegeven een string s en een lijst met woorden wordDict, geef true terug als s opgesplitst kan worden in een of meer woordenboekwoorden. Een woord mag zo vaak hergebruikt worden als je wilt.
| Invoer | Uitvoer | Waarom |
|---|---|---|
| s = "leetcode", ["leet","code"] | true | leet + code |
| s = "applepenapple", ["apple","pen"] | true | apple + pen + apple |
| s = "catsandog", ["cats","dog","sand","and","cat"] | false | Geen enkele opsplitsing dekt de laatste letters |
Vragen die je aan de interviewer kunt stellen: kan het woordenboek duplicaten bevatten, kan het leeg zijn, en is de string gegarandeerd niet leeg? (Controleer de constraints op de probleempagina.)
Brute force
Probeer elk eerste woord dat overeenkomt met het begin van de string, en recurseer dan op de rest. Bij een string als "aaaaaaaaaab" met de woorden a, aa, aaa bezoekt de recursie dezelfde suffixen steeds opnieuw, waardoor de tijd exponentieel is. De oplossing is om het antwoord voor elke startpositie te onthouden.
Aanpak 1: top-down met memoization
Definieer can(start) als de vraag of de suffix die bij start begint opgesplitst kan worden. Cache het resultaat.
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
Elk van de n startposities wordt eenmaal opgelost, en elk probeert tot n eindposities, met een slice en een set-lookup. Dat zijn O(n kwadraat) lookups, of O(n tot de derde macht) karakterwerk als je de kosten van het bouwen van elke slice meetelt. De ruimte is O(n) voor de cache en de recursie.
Aanpak 2: bottom-up dynamisch programmeren
Laat dp[i] true zijn als de eerste i karakters opgesplitst kunnen worden. dp[0] is true, want de lege prefix heeft geen woorden nodig. Zoek voor elke eindpositie een start waar dp[start] true is en s[start:end] een woord is.
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
Het beperken van start tot de laatste max_len posities is belangrijk. Een woordenboekwoord kan niet langer zijn dan het langste woord, dus het heeft geen zin om langere slices te controleren. Daardoor wordt de binnenste lus hooguit L stappen, en het geheel O(n keer L) lookups.
Trace
Voor s = "leetcode" met ["leet","code"]: dp[0] is true. dp[4] wordt true omdat dp[0] true is en "leet" een woord is. dp[8] wordt true omdat dp[4] true is en "code" een woord is. Het antwoord is dp[8], dat true is.
Veelgemaakte fouten
- Vergeten dat woorden hergebruikt mogen worden.
- True teruggeven zodra een prefix een woord is. De hele string moet gedekt worden.
- Elke slice bouwen zonder de max_len-beperking, wat correct is maar traag bij lange strings.
- Het woordenboek te laat omzetten naar een set, of helemaal niet, waardoor elke lookup een lijst doorloopt.
Edge cases om te testen
| Invoer | Verwacht |
|---|---|
| De string is zelf een woord | true |
| Een woord is een prefix van een ander ("a", "aa") | Wordt afgehandeld door de DP, niet door greedy matching |
| De string bevat een letter die in geen enkel woord voorkomt | false |
| Greedy faalt ("cars" met "car", "ca", "rs") | true, door ca + rs te nemen |
Hoe je het uitlegt in een interview
- Noem de brute force en waarom die werk herhaalt.
- Benoem het deelprobleem: kan de prefix van lengte i opgebouwd worden?
- Schrijf de recurrente betrekking in woorden op en codeer daarna de bottom-up versie.
- Noem de max_len-beperking en geef de complexiteit.
- Bied de gememoïseerde versie aan als de interviewer recursie prefereert.
Ik heb beide versies hierboven getest tegen een brute-force zoektocht op 20.000 willekeurige kleine invoeren, plus de drie voorbeelden in de tabel, voordat ik dit publiceerde. Zo'n snelle willekeurige controle is een goede gewoonte tijdens het oefenen.
Gerelateerde oefening
Zie onze Big O cheat sheet voor de complexiteitstermen, de LeetCode Blind 75 list voor wat je hierna kunt oefenen, en de coding interview assistant guide voor hoe je kunt oefenen.
Praat je aanpak hardop door terwijl je codeert. Een transcript laat zien of je de belangrijkste observatie hebt genoemd voordat je begon te schrijven. Volg de regels van de werkgever over AI-tools bij elke live assessment.
Oefen coding-interviews met YesToTheOffer
Leg je aanpak hardop uit en bekijk daarna je transcript. 30 gratis minuten, geen abonnement.