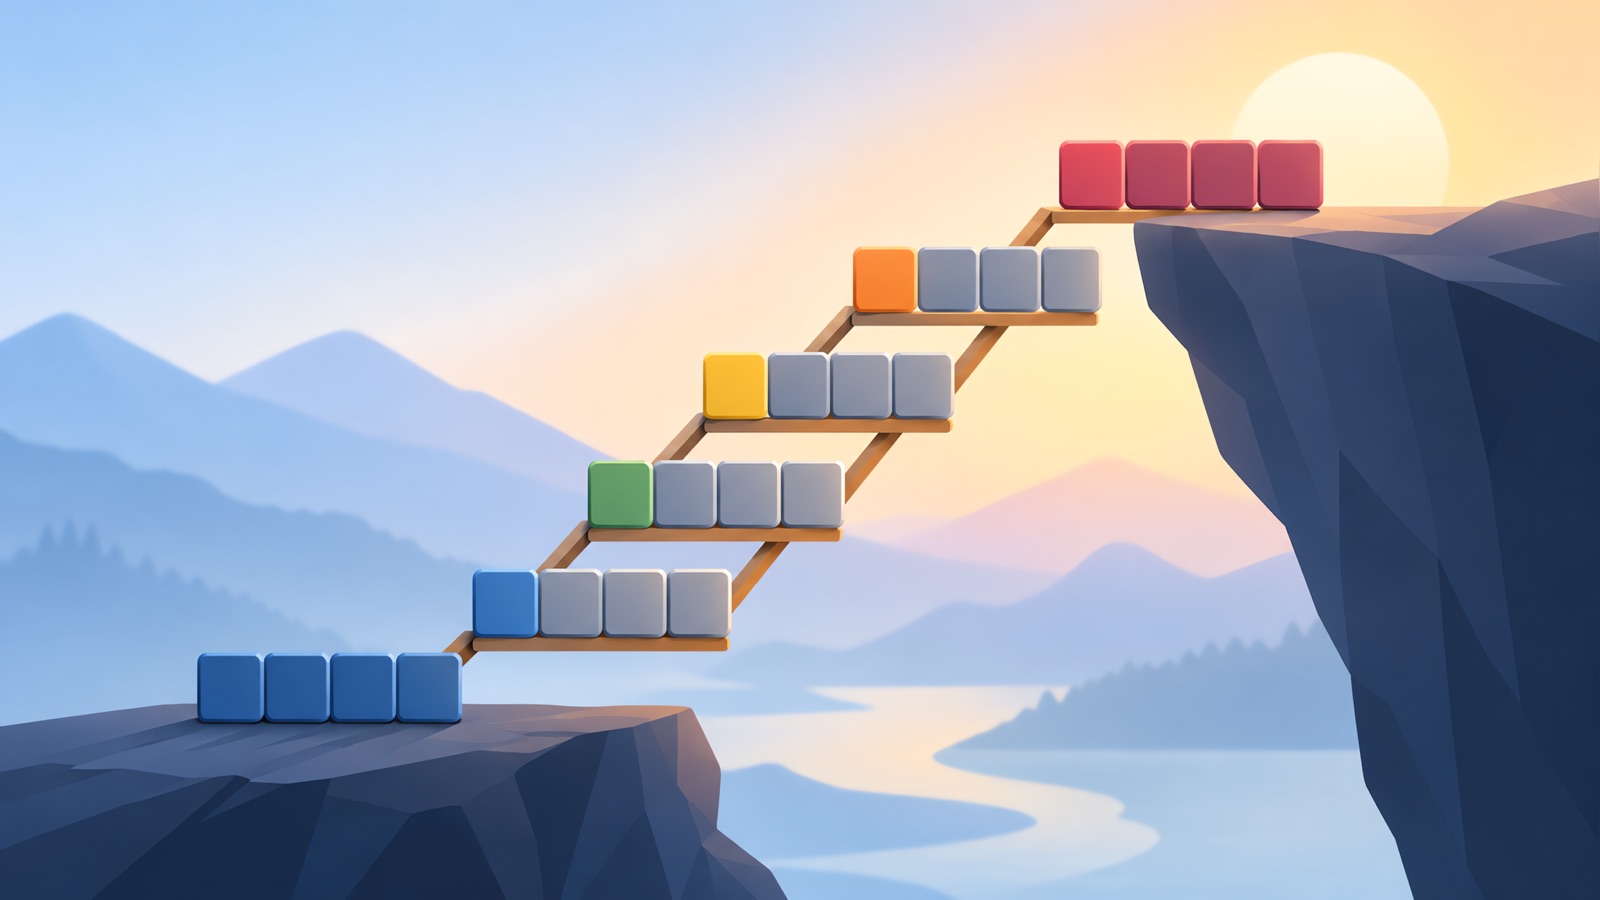
Word Ladder (LeetCode 127) vraagt om de lengte van de kortste keten van het ene woord naar het andere, waarbij je telkens één letter verandert en elke tussenstap in een gegeven lijst moet staan. Kortste pad met gelijke stappen betekent breadth-first search. De truc die het snel maakt, is woorden groeperen op wildcard-patronen zoals h*t, zodat je niet elk paar woorden hoeft te vergelijken.
Het probleem
Gegeven beginWord, endWord en een lijst met woorden, retourneer het aantal woorden in de kortste transformatiereeks van beginWord naar endWord, waarbij beide uiteinden meetellen. Elke stap verandert precies één letter, en elk woord waar je naartoe gaat moet in de lijst staan. Retourneer 0 als zo'n reeks niet bestaat.
| Input | Output | Waarom |
|---|---|---|
| hit naar cog, lijst hot dot dog lot log cog | 5 | hit, hot, dot, dog, cog |
| hit naar cog, lijst hot dot dog lot log | 0 | cog staat niet in de lijst |
Waarom breadth-first search
Beschouw elk woord als een knooppunt, met een rand tussen twee woorden die één letter verschillen. Elke rand kost één stap, dus de kortste reeks is het kortste pad in een ongewogen graaf, en breadth-first search vindt dat zodra het het eindwoord bereikt.
Brute force: randen opbouwen
Elk paar woorden vergelijken om te zien of ze één letter verschillen kost O(N kwadraat keer L) voor N woorden van lengte L. Met duizenden woorden is dat traag. Beter: genereer buren op basis van patronen.
Aanpak: wildcard-patronen
Vervang om de beurt elke letter door *. hot wordt *ot, h*t en ho*. Twee woorden zijn precies dan buren wanneer ze een patroon delen. Bouw een map van patroon naar de woorden die erbij passen, en voer daarmee de zoektocht uit.
from collections import deque, defaultdict

def ladder_length(begin_word, end_word, word_list):
    words = set(word_list)
    if end_word not in words:
        return 0
    patterns = defaultdict(list)
    for w in words | {begin_word}:
        for i in range(len(w)):
            patterns[w[:i] + "*" + w[i + 1:]].append(w)
    queue = deque([(begin_word, 1)])
    seen = {begin_word}
    while queue:
        word, steps = queue.popleft()
        if word == end_word:
            return steps
        for i in range(len(word)):
            key = word[:i] + "*" + word[i + 1:]
            for nxt in patterns[key]:
                if nxt not in seen:
                    seen.add(nxt)
                    queue.append((nxt, steps + 1))
            patterns[key] = []
    return 0
Twee details zijn belangrijk. Het beginwoord wordt toegevoegd aan de patroonmap, ook als het niet in de lijst staat, omdat je ervanuitgaat. En nadat de woorden van een patroon zijn bezocht, maakt patterns[key] = [] het leeg, zodat dezelfde groep niet opnieuw wordt gescand vanaf elk ander woord dat het patroon deelt. Dat houdt het totale werk lineair in het aantal patronen.
Complexiteit
Het opbouwen van patronen kost O(N keer L), en elke patroonstring kost O(L) om te bouwen, dus ongeveer O(N keer L kwadraat) in totaal. De zoektocht raakt elk woord één keer en elke patroongroep één keer, voor dezelfde bovengrens. Ruimte is O(N keer L kwadraat) voor de patroonmap, omdat elk woord onder L sleutels van lengte L wordt opgeslagen.
Sneller: bidirectioneel zoeken
Voer één zoektocht uit vanaf het beginwoord en één vanaf het eindwoord, en breid altijd de kleinere frontier uit. Ze ontmoeten elkaar in het midden, dus elke kant doorzoekt maar de helft van de diepte. Het is de moeite waard om te noemen als de interviewer vraagt hoe je het sneller maakt, en het is meer code dan de meeste interviews van je verwachten.
Veelgemaakte fouten
- Het aantal wijzigingen retourneren in plaats van het aantal woorden. De reeks bevat beginWord, dus het voorbeeld geeft 5, niet 4.
- Niet controleren of endWord in de lijst staat voordat je gaat zoeken.
- Buren opbouwen met een paarsgewijze vergelijking en een timeout krijgen.
- De zoektocht woorden opnieuw laten bezoeken, wat leidt tot een lus of vertraging.
- DFS gebruiken, wat een pad vindt maar niet het kortste.
Randgevallen om te testen
| Input | Verwacht |
|---|---|
| endWord ontbreekt in de lijst | 0 |
| Woorden van één letter | Elk ander woord in de lijst is één stap verwijderd |
| Eindwoord één stap van beginwoord | 2 |
| Woorden zonder verbinding | 0 |
Hoe je het uitlegt in een interview
- Herformuleer het als een graaf en zeg waarom breadth-first search het kortste pad vindt.
- Zeg dat de paarsgewijze vergelijking te traag is, en introduceer wildcard-patronen.
- Schrijf de patroonmap, de queue en de visited-set.
- Zeg dat je woorden telt, niet aanpassingen, en laat het eerste voorbeeld zien.
- Geef de complexiteit en noem bidirectioneel zoeken.
Ik heb de bovenstaande code getest tegen een gewone paarsgewijze breadth-first search op 20.000 willekeurige kleine woordenlijsten, plus de twee voorbeelden in de tabel, voordat ik het publiceerde. Zo'n snelle willekeurige controle is een goede gewoonte tijdens het oefenen.
Gerelateerde oefening
Zie onze Big O cheat sheet voor de complexiteitstermen, de LeetCode Blind 75 list voor wat je hierna kunt oefenen, en de coding interview assistant guide voor hoe je oefent.
Praat je aanpak hardop door terwijl je codeert. Een transcript laat zien of je de belangrijkste observatie hebt genoemd voordat je begon te schrijven. Volg de regels van de werkgever over AI-tools bij elke live assessment.
Oefen sollicitatiegesprekken met programmeren met YesToTheOffer
Leg je aanpak hardop uit en bekijk daarna je transcript. 30 gratis minuten, geen abonnement.