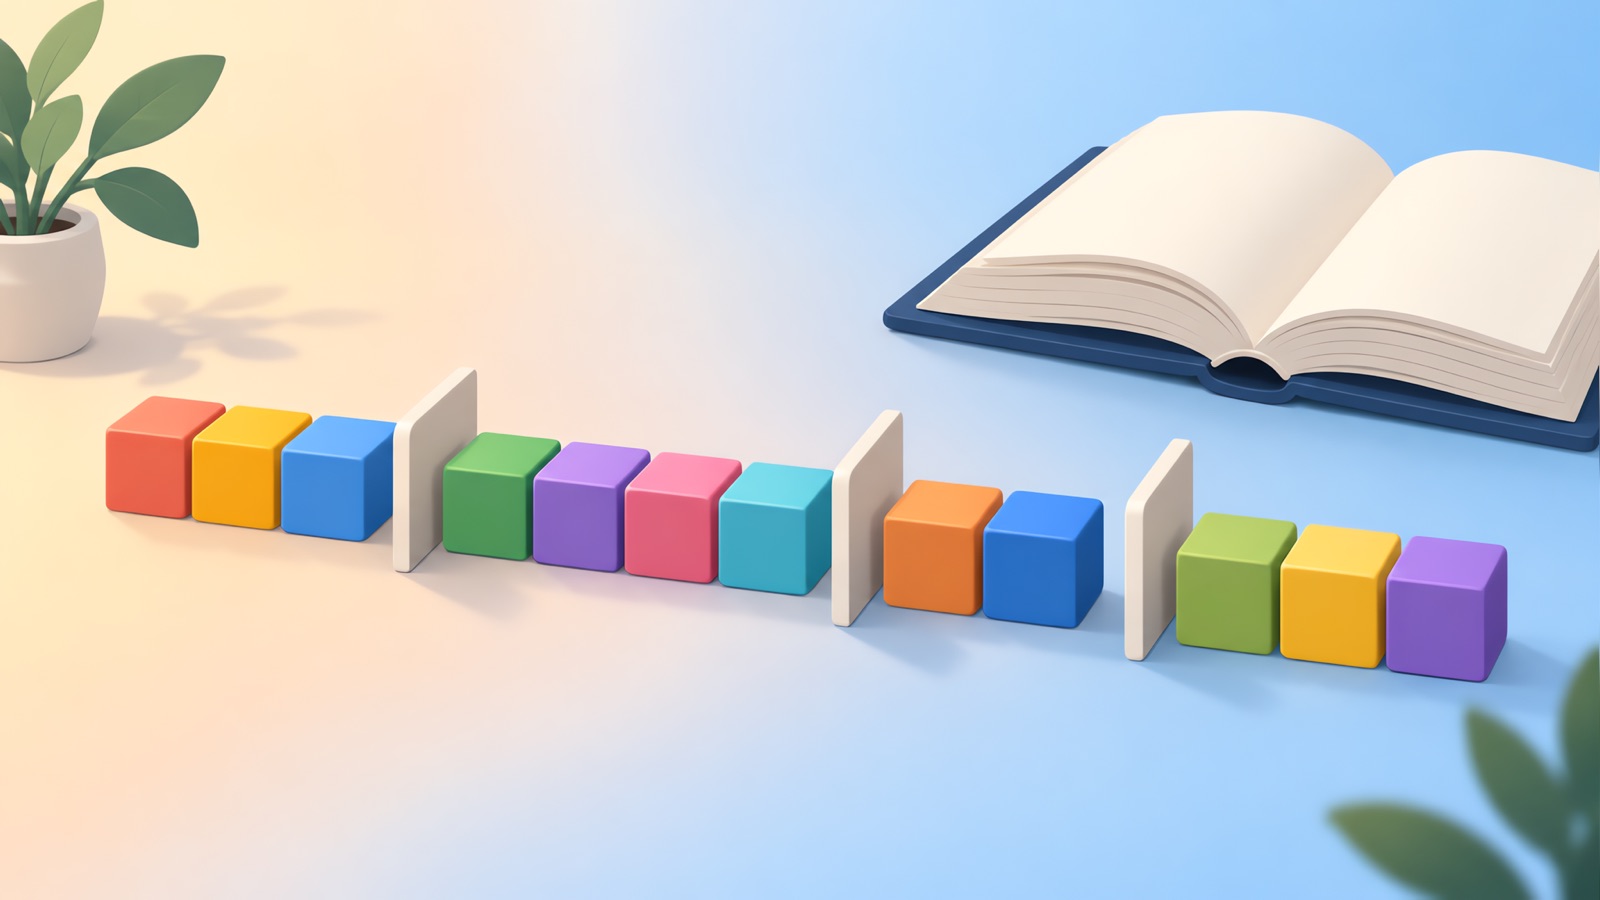
Word Break(LeetCode 139)는 문자열을 사전에 있는 단어들의 나열로 쪼갤 수 있는지 묻는 문제입니다. 깔끔한 답은 접두사에 대한 동적 계획법입니다. 어떤 접두사가 만들어질 수 있다는 것은, 더 짧은 만들 수 있는 접두사 뒤에 사전 단어가 이어지는 경우입니다. 뒤를 얼마나 되돌아볼지 제한하면 O(n × L)에 실행됩니다. 여기서 L은 가장 긴 단어의 길이입니다.
문제
문자열 s와 단어 목록 wordDict가 주어졌을 때, s를 하나 이상의 사전 단어로 쪼갤 수 있으면 true를 반환합니다. 단어는 원하는 만큼 여러 번 재사용할 수 있습니다.
| 입력 | 출력 | 이유 |
|---|---|---|
| s = "leetcode", ["leet","code"] | true | leet + code |
| s = "applepenapple", ["apple","pen"] | true | apple + pen + apple |
| s = "catsandog", ["cats","dog","sand","and","cat"] | false | 마지막 글자들을 덮는 분할이 없음 |
면접관에게 물어볼 것: 사전에 중복이 있을 수 있는지, 비어 있을 수 있는지, 문자열이 비어 있지 않다고 보장되는지. (문제 페이지의 제약 조건을 확인하세요.)
완전 탐색
문자열의 시작 부분과 일치하는 모든 첫 단어를 시도한 뒤, 나머지에 대해 재귀 호출합니다. "aaaaaaaaaab" 같은 문자열과 단어 a, aa, aaa가 있으면 재귀가 같은 접미사를 여러 번 다시 방문하므로 시간이 지수적으로 늘어납니다. 해결책은 각 시작 위치에 대한 답을 기억하는 것입니다.
접근법 1: 메모이제이션을 곁들인 하향식
can(start)를 start에서 시작하는 접미사를 쪼갤 수 있는지로 정의합니다. 결과를 캐시합니다.
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
n개의 시작 위치 각각은 한 번씩 풀리고, 각각은 최대 n개의 끝 위치를 시도하며, 슬라이스와 집합 조회를 합니다. 이는 O(n 제곱)번의 조회이고, 각 슬라이스를 만드는 비용을 계산하면 O(n 세제곱)의 문자 작업입니다. 공간은 캐시와 재귀를 위해 O(n)입니다.
접근법 2: 상향식 동적 계획법
dp[i]를 처음 i개 문자를 쪼갤 수 있으면 true로 둡니다. dp[0]은 true입니다. 빈 접두사는 단어가 필요 없기 때문입니다. 각 끝 위치마다 dp[start]가 true이고 s[start:end]가 단어인 시작 위치를 찾습니다.
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
start를 마지막 max_len 위치로 제한하는 것이 중요합니다. 사전 단어는 가장 긴 단어보다 길 수 없으므로, 더 긴 슬라이스를 확인할 이유가 없습니다. 그러면 안쪽 루프가 최대 L 단계가 되고, 전체가 O(n × L)번의 조회가 됩니다.
추적
s = "leetcode"와 ["leet","code"]의 경우: dp[0]은 true입니다. dp[0]이 true이고 "leet"이 단어이므로 dp[4]가 true가 됩니다. dp[4]가 true이고 "code"가 단어이므로 dp[8]이 true가 됩니다. 답은 dp[8]이고, 이는 true입니다.
흔한 실수
- 단어를 재사용할 수 있다는 것을 잊는 것.
- 어떤 접두사가 단어이기만 하면 바로 true를 반환하는 것. 전체 문자열이 덮여야 합니다.
- max_len 제한 없이 모든 슬라이스를 만드는 것. 정답이긴 하지만 긴 문자열에서 느립니다.
- 사전을 집합으로 늦게, 혹은 아예 변환하지 않아서, 조회할 때마다 리스트를 훑는 것.
테스트할 경계 사례
| 입력 | 기대값 |
|---|---|
| 문자열 자체가 단어 | true |
| 어떤 단어가 다른 단어의 접두사 ("a", "aa") | 탐욕적 매칭이 아니라 DP가 처리 |
| 어떤 단어에도 없는 글자가 문자열에 있음 | false |
| 탐욕적 방식이 실패 ("cars"와 "car", "ca", "rs") | true, ca + rs를 취함으로써 |
면접에서 설명하는 방법
- 완전 탐색과 그것이 왜 작업을 반복하는지 말합니다.
- 부분 문제를 진술합니다: 길이 i인 접두사를 만들 수 있는가?
- 점화식을 말로 쓴 뒤, 상향식 버전을 코딩합니다.
- max_len 제한을 언급하고 복잡도를 제시합니다.
- 면접관이 재귀를 선호하면 메모이제이션 버전을 제안합니다.
저는 위의 두 버전을 20,000개의 무작위 소규모 입력에 대한 완전 탐색과, 표에 있는 세 가지 예제에 대해 게시 전에 테스트했습니다. 이런 간단한 무작위 검사는 연습할 때 좋은 습관입니다.
관련 연습
복잡도 용어는 Big O 치트 시트를, 다음에 무엇을 연습할지는 LeetCode Blind 75 목록을, 연습 방법은 코딩 면접 어시스턴트 가이드를 참고하세요.
코드를 작성하면서 접근법을 소리 내어 설명하세요. 녹취록을 보면 핵심 관찰을 코드 작성 전에 말했는지 알 수 있습니다. 실시간 평가에서는 AI 도구에 관한 고용주의 규칙을 따르세요.
YesToTheOffer와 함께 코딩 인터뷰를 연습하세요
접근 방식을 소리 내어 설명한 뒤, 이후에 녹취록을 검토하세요. 30분 무료, 구독 없음.