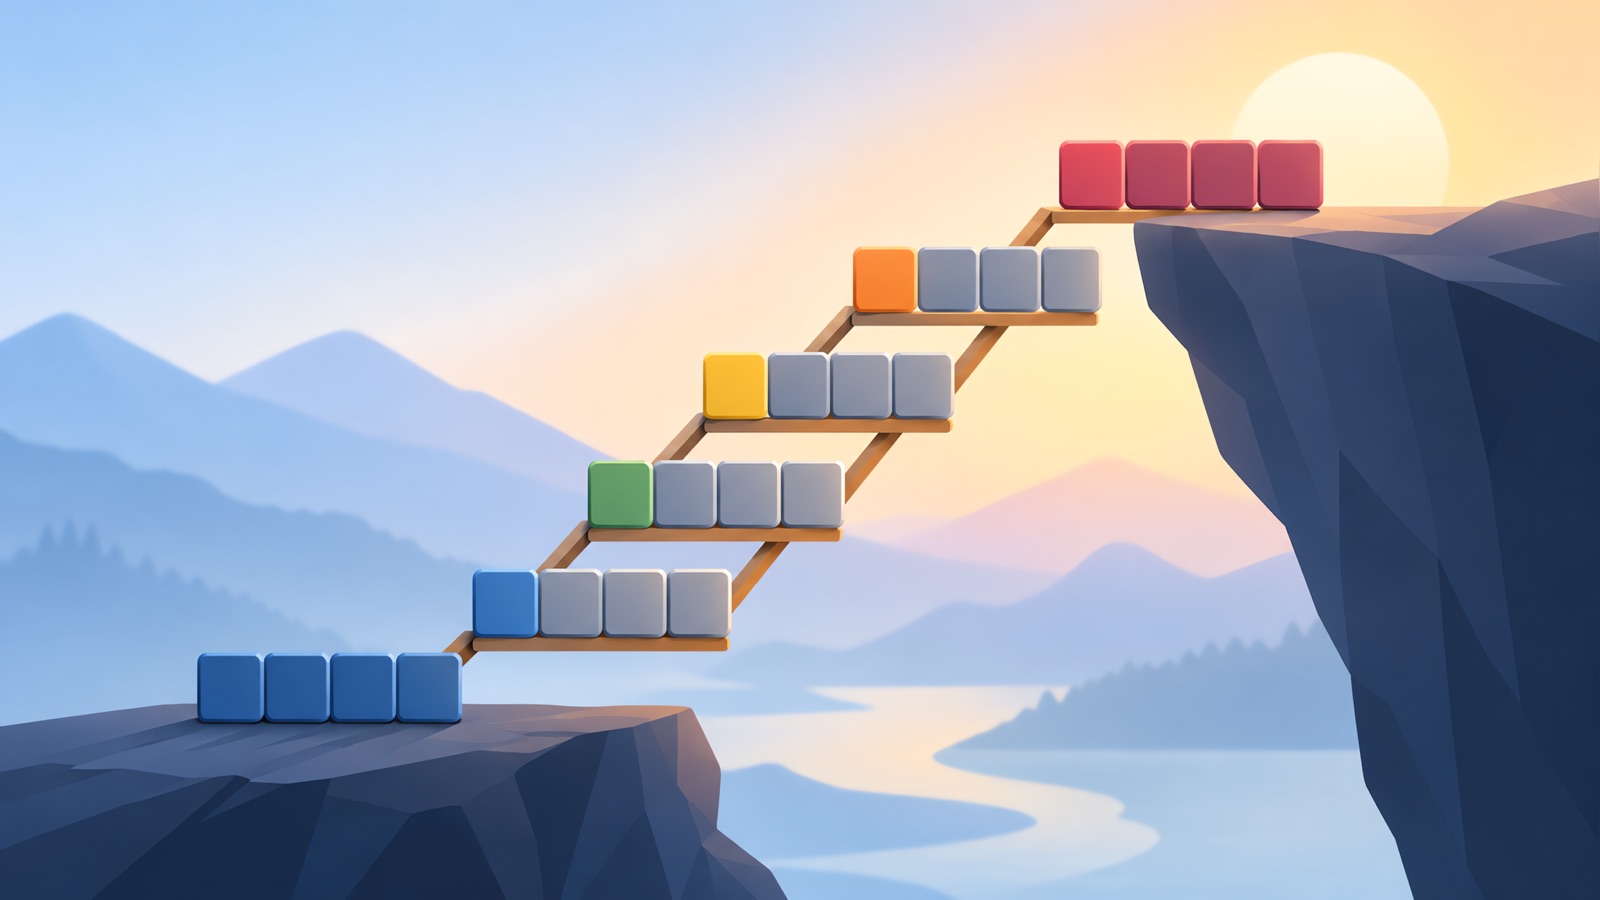
Word Ladder(LeetCode 127)는 한 번에 한 글자씩 바꾸면서, 모든 단계가 주어진 목록 안에 있어야 한다는 조건에서 한 단어에서 다른 단어로 가는 가장 짧은 체인의 길이를 구하는 문제입니다. 각 단계의 비용이 같은 최단 경로라면 너비 우선 탐색(BFS)입니다. 이 문제를 빠르게 만드는 핵심은 h*t 같은 와일드카드 패턴으로 단어를 묶어, 모든 단어 쌍을 일일이 비교하지 않는 것입니다.
문제
beginWord, endWord, 그리고 단어 목록이 주어지면, beginWord에서 endWord까지 가는 가장 짧은 변환 시퀀스에 포함된 단어 수를 양 끝을 포함해서 반환합니다. 각 단계에서는 정확히 한 글자만 바뀌고, 이동하는 모든 단어는 목록 안에 있어야 합니다. 그런 시퀀스가 없으면 0을 반환합니다.
| 입력 | 출력 | 이유 |
|---|---|---|
| hit에서 cog, 목록 hot dot dog lot log cog | 5 | hit, hot, dot, dog, cog |
| hit에서 cog, 목록 hot dot dog lot log | 0 | cog가 목록에 없음 |
왜 너비 우선 탐색인가
각 단어를 노드로 보고, 한 글자만 다른 두 단어 사이에 간선을 둡니다. 모든 간선의 비용이 한 단계이므로, 가장 짧은 시퀀스는 가중치 없는 그래프의 최단 경로이고, 너비 우선 탐색이 끝 단어에 처음 도달하는 순간 그 경로를 찾습니다.
완전탐색 방식의 간선 구성
모든 단어 쌍을 비교해서 한 글자만 다른지 확인하는 방법은 길이 L인 단어 N개에 대해 O(N 제곱 곱하기 L)이 걸립니다. 단어가 수천 개면 너무 느립니다. 더 나은 방법은 패턴으로 이웃을 생성하는 것입니다.
접근법: 와일드카드 패턴
각 글자를 차례로 *로 바꿉니다. hot은 *ot, h*t, ho*가 됩니다. 두 단어는 같은 패턴을 공유할 때 정확히 이웃입니다. 패턴에서 그 패턴에 맞는 단어들로 가는 맵을 만든 뒤, 그것을 이용해 탐색을 실행합니다.
from collections import deque, defaultdict

def ladder_length(begin_word, end_word, word_list):
    words = set(word_list)
    if end_word not in words:
        return 0
    patterns = defaultdict(list)
    for w in words | {begin_word}:
        for i in range(len(w)):
            patterns[w[:i] + "*" + w[i + 1:]].append(w)
    queue = deque([(begin_word, 1)])
    seen = {begin_word}
    while queue:
        word, steps = queue.popleft()
        if word == end_word:
            return steps
        for i in range(len(word)):
            key = word[:i] + "*" + word[i + 1:]
            for nxt in patterns[key]:
                if nxt not in seen:
                    seen.add(nxt)
                    queue.append((nxt, steps + 1))
            patterns[key] = []
    return 0
두 가지 세부 사항이 중요합니다. 시작 단어는 목록에 없더라도 패턴 맵에 추가합니다. 시작점이기 때문입니다. 그리고 어떤 패턴의 단어들을 방문한 뒤에는 patterns[key] = []로 비워서, 같은 패턴을 공유하는 다른 단어들마다 같은 그룹을 다시 훑지 않도록 합니다. 이렇게 하면 전체 작업량이 패턴 수에 대해 선형으로 유지됩니다.
복잡도
패턴을 만드는 데 O(N 곱하기 L)이 걸리고, 각 패턴 문자열을 만드는 데 O(L)이 걸리므로, 총합은 대략 O(N 곱하기 L 제곱)입니다. 탐색은 각 단어를 한 번, 각 패턴 그룹을 한 번씩 건드리므로 같은 한계입니다. 공간은 패턴 맵에 O(N 곱하기 L 제곱)입니다. 각 단어가 길이 L인 키 L개 아래에 저장되기 때문입니다.
더 빠르게: 양방향 탐색
시작 단어에서 한 번, 끝 단어에서 한 번 탐색을 실행하고, 항상 더 작은 프런티어를 확장합니다. 양쪽이 중간에서 만나므로 각 방향은 깊이의 절반만 탐색합니다. 면접관이 속도를 높이는 방법을 물으면 언급할 가치가 있고, 대부분의 면접에서 기대하는 것보다 코드가 더 많습니다.
흔한 실수
- 단어 수가 아니라 변경 횟수를 반환하는 것. 시퀀스에는 beginWord가 포함되므로, 예시는 4가 아니라 5입니다.
- 탐색 전에 endWord가 목록에 있는지 확인하지 않는 것.
- 이웃을 쌍별 비교로 구성해서 시간 초과가 나는 것.
- 탐색이 단어를 다시 방문하도록 놔두는 것. 루프가 생기거나 느려집니다.
- DFS를 사용하는 것. 경로는 찾지만 최단 경로는 아닙니다.
테스트할 엣지 케이스
| 입력 | 기대값 |
|---|---|
| endWord가 목록에 없음 | 0 |
| 한 글자 단어 | 목록의 다른 단어는 모두 한 단계 거리 |
| 끝 단어가 시작 단어에서 한 단계 | 2 |
| 연결이 없는 단어들 | 0 |
면접에서 설명하는 방법
- 그래프로 재구성하고, 너비 우선 탐색이 왜 최단 경로를 찾는지 말합니다.
- 쌍별 비교는 너무 느리다고 말하고, 와일드카드 패턴을 소개합니다.
- 패턴 맵, 큐, 방문 집합을 작성합니다.
- 편집 횟수가 아니라 단어 수를 센다고 말하고, 첫 번째 예시를 보여줍니다.
- 복잡도를 제시하고 양방향 탐색을 언급합니다.
저는 위 코드를 게시하기 전에 20,000개의 무작위 소규모 단어 목록과 표의 두 예시에 대해, 단순한 쌍별 너비 우선 탐색과 비교해 테스트했습니다. 이런 간단한 무작위 검증은 연습할 때 들이는 좋은 습관입니다.
관련 연습
복잡도 용어는 Big O 치트 시트를, 다음에 무엇을 연습할지는 LeetCode Blind 75 목록을, 연습 방법은 코딩 인터뷰 어시스턴트 가이드를 참고하세요.
코드를 작성하면서 접근법을 소리 내어 설명하세요. 녹취록을 보면 코드를 쓰기 전에 핵심 관찰을 말했는지 알 수 있습니다. 실시간 평가에서는 AI 도구에 관한 회사 규칙을 따르세요.
YesToTheOffer와 함께 코딩 인터뷰를 연습하세요
접근 방식을 소리 내어 설명한 다음, 나중에 녹취록을 검토하세요. 30분 무료, 구독 없음.