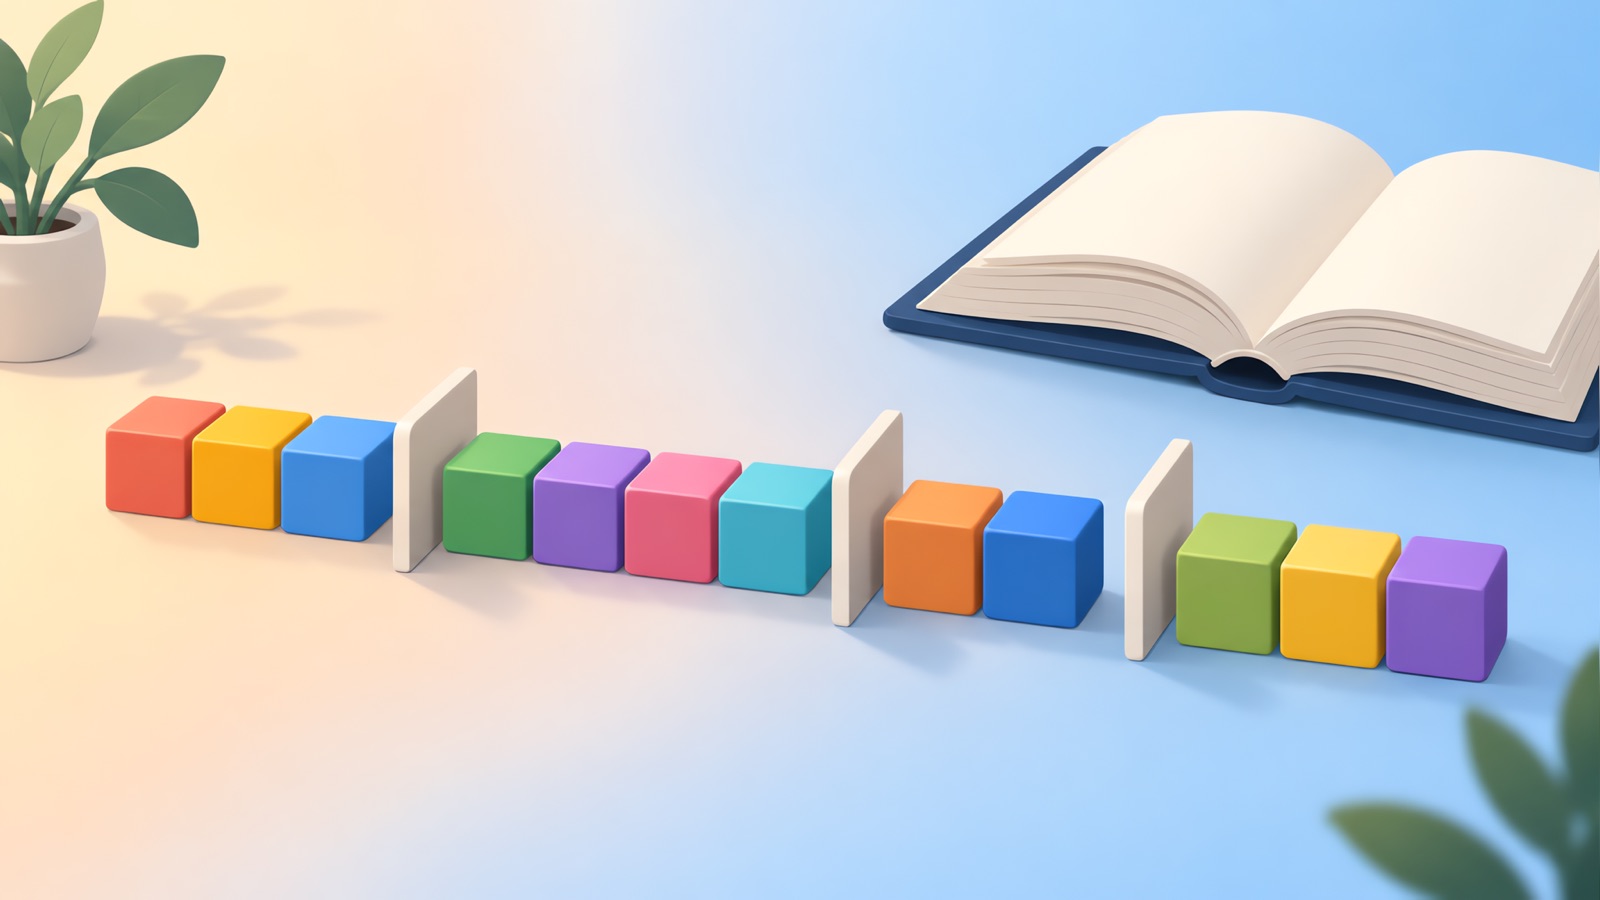
Word Break (LeetCode 139) chiede se una stringa può essere suddivisa in una sequenza di parole che compaiono tutte in un dizionario. La soluzione pulita è la programmazione dinamica sui prefissi: un prefisso può essere costruito se un prefisso più corto e già costruibile è seguito da una parola del dizionario. Il tempo di esecuzione è O(n per L), dove L è la parola più lunga, una volta che si limita quanto indietro guardare.
Il problema
Data una stringa s e una lista di parole wordDict, restituisci true se s può essere suddivisa in una o più parole del dizionario. Una parola può essere riutilizzata quante volte si vuole.
| Input | Output | Perché |
|---|---|---|
| s = "leetcode", ["leet","code"] | true | leet + code |
| s = "applepenapple", ["apple","pen"] | true | apple + pen + apple |
| s = "catsandog", ["cats","dog","sand","and","cat"] | false | Nessuna suddivisione copre le ultime lettere |
Domande da fare al colloquio: il dizionario può contenere duplicati, può essere vuoto, e la stringa è garantita non vuota? (Controlla i vincoli nella pagina del problema.)
Forza bruta
Prova ogni prima parola che corrisponde all'inizio della stringa, poi ricorre sul resto. Con una stringa come "aaaaaaaaaab" e le parole a, aa, aaa, la ricorsione rivisita gli stessi suffissi molte volte, quindi il tempo è esponenziale. La soluzione è memorizzare la risposta per ogni posizione di partenza.
Approccio 1: top-down con memoizzazione
Definisci can(start) come se il suffisso che inizia da start può essere suddiviso. Memorizza il risultato.
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
Ognuna delle n posizioni di partenza viene risolta una volta, e ognuna prova fino a n posizioni finali, con uno slice e una ricerca nel set. Sono O(n al quadrato) ricerche, o O(n al cubo) di lavoro sui caratteri se conti il costo di costruire ogni slice. Lo spazio è O(n) per la cache e la ricorsione.
Approccio 2: programmazione dinamica bottom-up
Sia dp[i] true se i primi i caratteri possono essere suddivisi. dp[0] è true, dato che il prefisso vuoto non richiede parole. Per ogni posizione finale, cerca una posizione iniziale dove dp[start] è true e s[start:end] è una parola.
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
Limitare start alle ultime max_len posizioni è importante. Una parola del dizionario non può essere più lunga della parola più lunga, quindi non ha senso controllare slice più lunghi. Questo trasforma il ciclo interno in al massimo L passi, e l'intero algoritmo in O(n per L) ricerche.
Traccia
Per s = "leetcode" con ["leet","code"]: dp[0] è true. dp[4] diventa true perché dp[0] è true e "leet" è una parola. dp[8] diventa true perché dp[4] è true e "code" è una parola. La risposta è dp[8], che è true.
Errori comuni
- Dimenticare che le parole possono essere riutilizzate.
- Restituire true appena un prefisso è una parola. L'intera stringa deve essere coperta.
- Costruire ogni slice senza il limite max_len, che è corretto ma lento su stringhe lunghe.
- Convertire il dizionario in un set in ritardo, o non farlo affatto, così ogni ricerca scorre una lista.
Casi limite da testare
| Input | Atteso |
|---|---|
| La stringa è essa stessa una parola | true |
| Una parola è prefisso di un'altra ("a", "aa") | Gestito dalla DP, non dal matching greedy |
| La stringa ha una lettera che nessuna parola contiene | false |
| Il greedy fallisce ("cars" con "car", "ca", "rs") | true, prendendo ca + rs |
Come spiegarlo in un colloquio
- Descrivi la forza bruta e perché ripete il lavoro.
- Enuncia il sottoproblema: il prefisso di lunghezza i può essere costruito?
- Scrivi la ricorrenza a parole, poi codifica la versione bottom-up.
- Menziona il limite max_len e fornisci la complessità.
- Proponi la versione memoizzata se l'intervistatore preferisce la ricorsione.
Ho testato entrambe le versioni qui sopra contro una ricerca a forza bruta su 20.000 input casuali di piccole dimensioni, più i tre esempi nella tabella, prima di pubblicare. Un rapido controllo casuale come questo è una buona abitudine quando ti eserciti.
Esercizi correlati
Consulta il nostro Big O cheat sheet per i termini di complessità, la LeetCode Blind 75 list per cosa esercitare dopo, e la coding interview assistant guide per come esercitarti.
Ragiona ad alta voce sul tuo approccio mentre scrivi il codice. Una trascrizione mostra se hai enunciato l'osservazione chiave prima di scrivere. Segui le regole del datore di lavoro sugli strumenti di AI in qualsiasi valutazione dal vivo.
Esercitati per i colloqui di programmazione con YesToTheOffer
Spiega il tuo approccio ad alta voce, poi rileggi la tua trascrizione. 30 minuti gratuiti, nessun abbonamento.