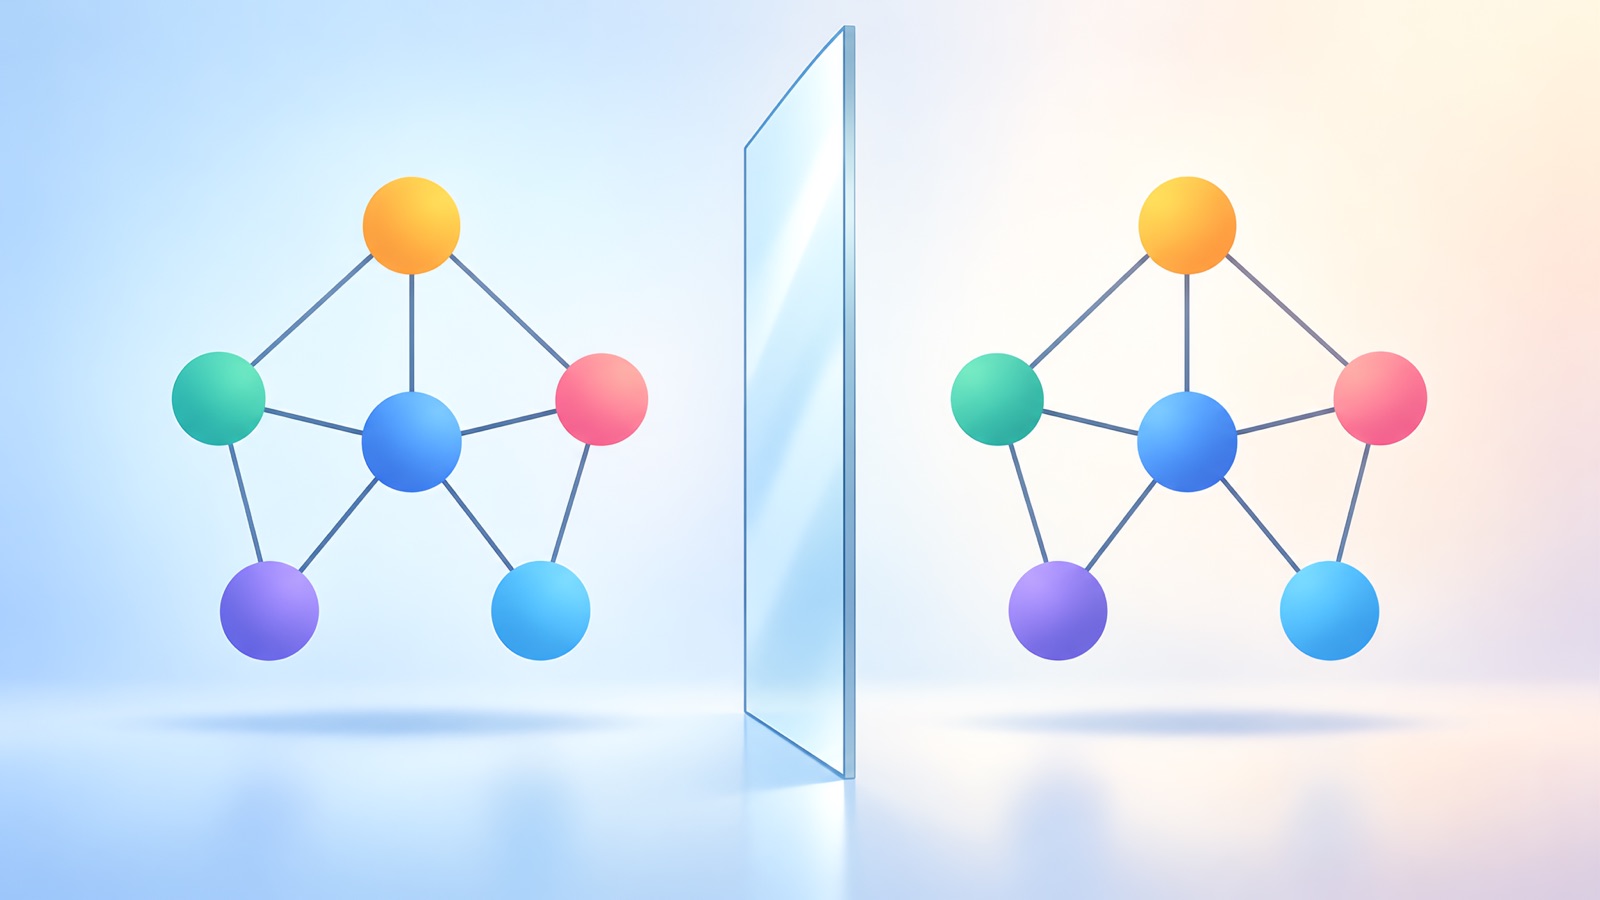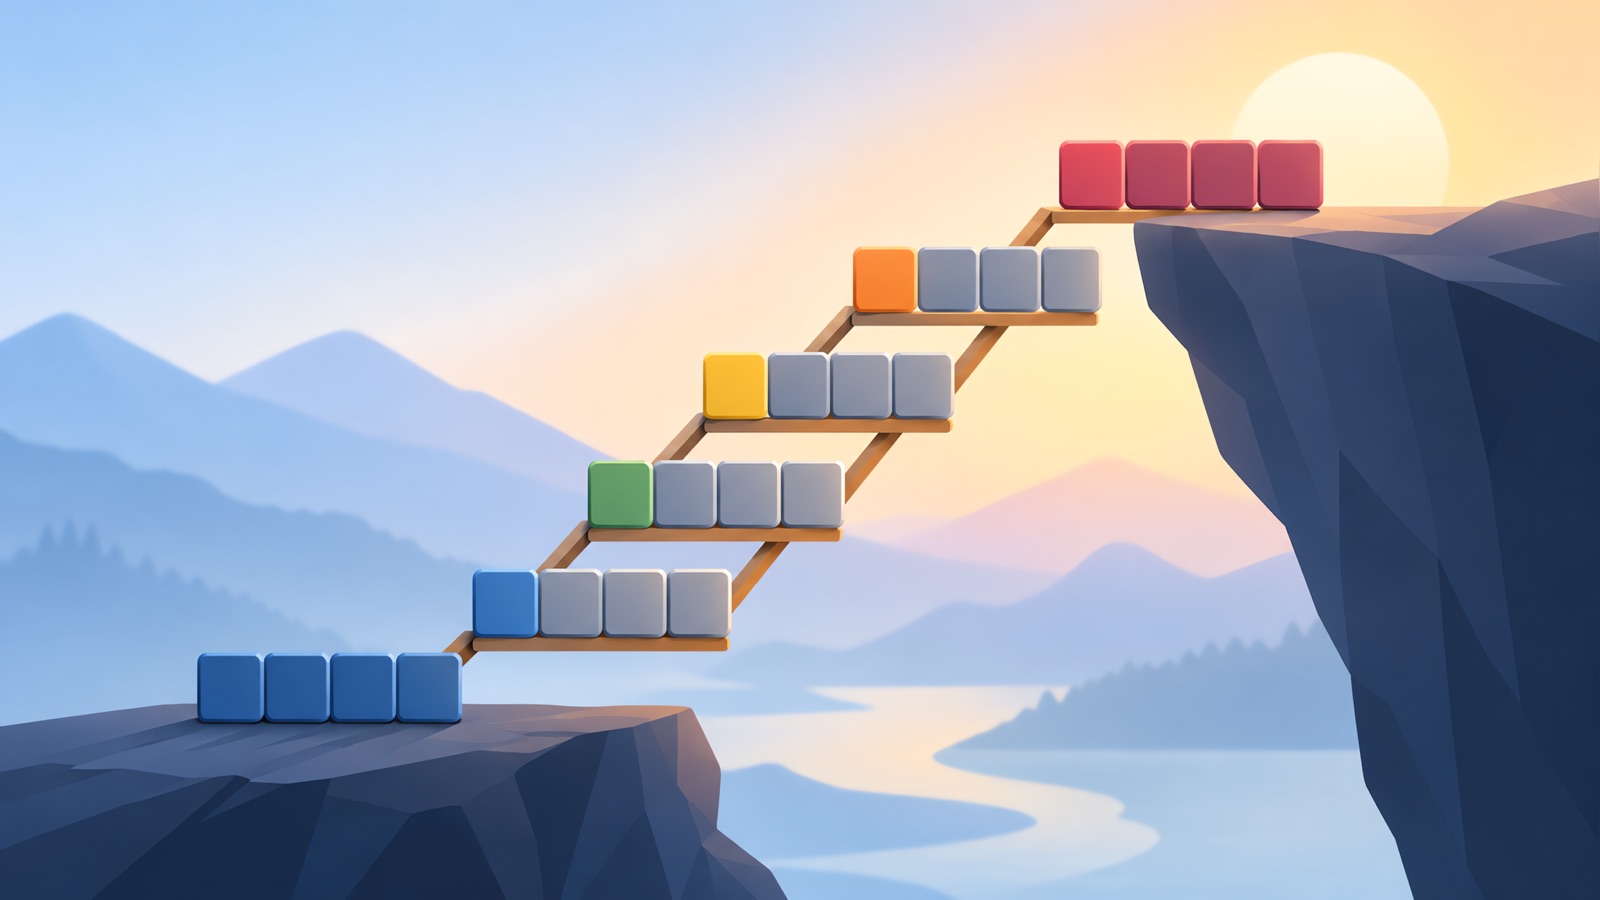
Word Ladder (LeetCode 127) chiede la lunghezza della catena più breve da una parola a un'altra, cambiando una lettera alla volta, dove ogni passaggio deve essere in una lista data. Cammino più breve con passi uguali significa ricerca in ampiezza. Il trucco che la rende veloce è raggruppare le parole per pattern con caratteri jolly come h*t, così non devi confrontare ogni coppia di parole.
Il problema
Dati beginWord, endWord e una lista di parole, restituisci il numero di parole nella sequenza di trasformazione più breve da beginWord a endWord, contando entrambi gli estremi. Ogni passaggio cambia esattamente una lettera, e ogni parola a cui ti sposti deve essere nella lista. Restituisci 0 se non esiste una tale sequenza.
| Input | Output | Perché |
|---|---|---|
| Da hit a cog, lista hot dot dog lot log cog | 5 | hit, hot, dot, dog, cog |
| Da hit a cog, lista hot dot dog lot log | 0 | cog non è nella lista |
Perché la ricerca in ampiezza
Tratta ogni parola come un nodo, con un arco tra due parole che differiscono di una lettera. Ogni arco costa un passo, quindi la sequenza più breve è il cammino più breve in un grafo non pesato, e la ricerca in ampiezza lo trova la prima volta che raggiunge la parola finale.
Costruzione degli archi con forza bruta
Confrontare ogni coppia di parole per vedere se differiscono di una lettera costa O(N al quadrato per L) per N parole di lunghezza L. Con migliaia di parole è lento. Meglio: generare i vicini dai pattern.
Approccio: pattern con caratteri jolly
Sostituisci a turno ogni lettera con *. hot diventa *ot, h*t e ho*. Due parole sono vicine esattamente quando condividono un pattern. Costruisci una mappa da pattern alle parole che vi rientrano, poi esegui la ricerca usandola.
from collections import deque, defaultdict

def ladder_length(begin_word, end_word, word_list):
    words = set(word_list)
    if end_word not in words:
        return 0
    patterns = defaultdict(list)
    for w in words | {begin_word}:
        for i in range(len(w)):
            patterns[w[:i] + "*" + w[i + 1:]].append(w)
    queue = deque([(begin_word, 1)])
    seen = {begin_word}
    while queue:
        word, steps = queue.popleft()
        if word == end_word:
            return steps
        for i in range(len(word)):
            key = word[:i] + "*" + word[i + 1:]
            for nxt in patterns[key]:
                if nxt not in seen:
                    seen.add(nxt)
                    queue.append((nxt, steps + 1))
            patterns[key] = []
    return 0
Due dettagli contano. La parola iniziale viene aggiunta alla mappa dei pattern anche se non è nella lista, dato che parti da lì. E dopo che le parole di un pattern sono state visitate, patterns[key] = [] lo svuota così lo stesso gruppo non viene scansionato di nuovo da ogni altra parola che condivide il pattern. Questo mantiene il lavoro totale lineare nel numero di pattern.
Complessità
Costruire i pattern richiede O(N per L), e ogni stringa di pattern costa O(L) da costruire, quindi circa O(N per L al quadrato) in totale. La ricerca tocca ogni parola una volta e ogni gruppo di pattern una volta, per lo stesso limite. Lo spazio è O(N per L al quadrato) per la mappa dei pattern, dato che ogni parola è memorizzata sotto L chiavi di lunghezza L.
Andare più veloce: ricerca bidirezionale
Esegui una ricerca dalla parola iniziale e una dalla parola finale, ed espandi sempre il fronte più piccolo. Si incontrano a metà, quindi ogni lato cerca solo metà della profondità. Vale la pena menzionarla se l'intervistatore chiede come velocizzarla, ed è più codice di quanto la maggior parte delle interviste si aspetti che tu scriva.
Errori comuni
- Restituire il numero di cambi invece del numero di parole. La sequenza include beginWord, quindi l'esempio dà 5, non 4.
- Non verificare che endWord sia nella lista prima di cercare.
- Costruire i vicini con un confronto a coppie e andare in timeout.
- Lasciare che la ricerca rivisiti le parole, il che crea cicli o la rallenta.
- Usare la DFS, che trova un cammino ma non quello più breve.
Casi limite da testare
| Input | Atteso |
|---|---|
| endWord assente dalla lista | 0 |
| Parole di una lettera | Qualsiasi altra parola nella lista è a un passo |
| Parola finale a un passo da quella iniziale | 2 |
| Parole senza connessione | 0 |
Come spiegarlo in un colloquio
- Riformula il problema come un grafo e spiega perché la ricerca in ampiezza trova il cammino più breve.
- Di' che il confronto a coppie è troppo lento e introduci i pattern con caratteri jolly.
- Scrivi la mappa dei pattern, la coda e l'insieme dei visitati.
- Di' che conti le parole, non le modifiche, e mostra il primo esempio.
- Fornisci la complessità e menziona la ricerca bidirezionale.
Ho testato il codice qui sopra contro una semplice ricerca in ampiezza a coppie su 20.000 piccole liste di parole casuali, più i due esempi nella tabella, prima di pubblicare. Un rapido controllo casuale come questo è una buona abitudine quando ti eserciti.
Esercizi correlati
Consulta il nostro cheat sheet sulla notazione Big O per i termini di complessità, la lista LeetCode Blind 75 per cosa esercitare dopo, e la guida all'assistente per colloqui di programmazione per come esercitarti.
Ragiona ad alta voce sul tuo approccio mentre scrivi il codice. Una trascrizione mostra se hai enunciato l'osservazione chiave prima di scrivere. Segui le regole del datore di lavoro sugli strumenti di IA in qualsiasi valutazione dal vivo.
Esercitati per i colloqui di programmazione con YesToTheOffer
Spiega il tuo approccio ad alta voce, poi rileggi la tua trascrizione in seguito. 30 minuti gratuiti, nessun abbonamento.