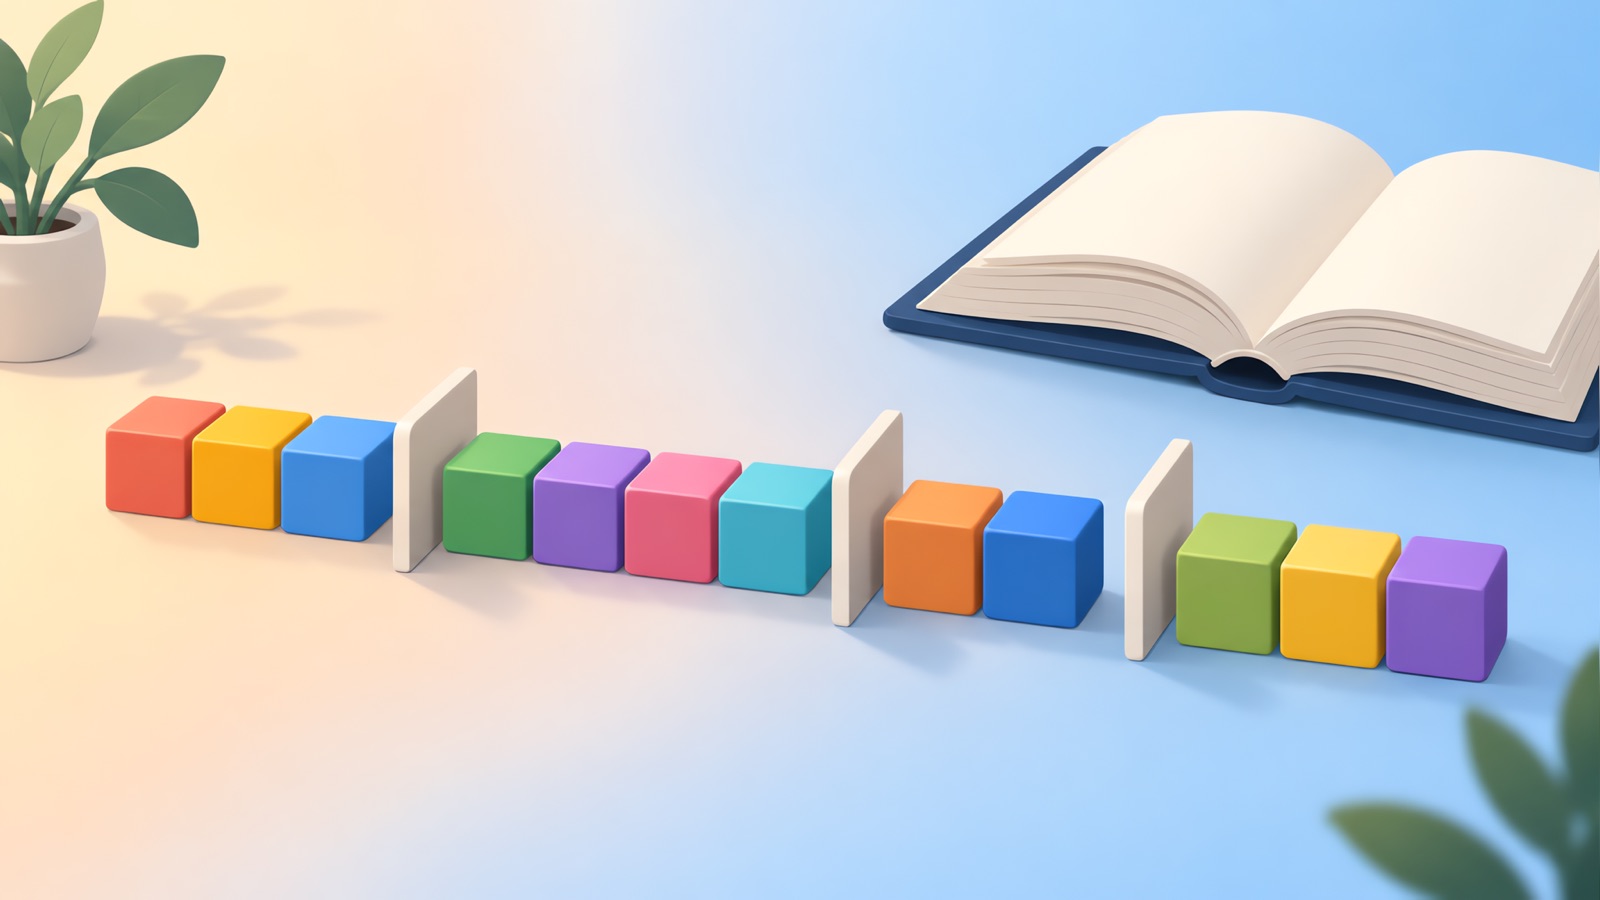
Word Break (LeetCode 139) consiste à déterminer si une chaîne peut être découpée en une suite de mots figurant tous dans un dictionnaire. La solution élégante repose sur la programmation dynamique sur les préfixes : un préfixe est constructible si un préfixe plus court et constructible est suivi d'un mot du dictionnaire. La complexité est en O(n fois L), où L est la longueur du mot le plus long, à condition de limiter la profondeur de recherche vers l'arrière.
Le problème
Étant donné une chaîne s et une liste de mots wordDict, renvoyez true si s peut être découpée en un ou plusieurs mots du dictionnaire. Un mot peut être réutilisé autant de fois que nécessaire.
| Entrée | Sortie | Pourquoi |
|---|---|---|
| s = "leetcode", ["leet","code"] | true | leet + code |
| s = "applepenapple", ["apple","pen"] | true | apple + pen + apple |
| s = "catsandog", ["cats","dog","sand","and","cat"] | false | Aucun découpage ne couvre les dernières lettres |
Questions à poser à l'interviewer : le dictionnaire peut-il contenir des doublons, peut-il être vide, et la chaîne est-elle garantie non vide ? (Vérifiez les contraintes sur la page du problème.)
Force brute
On essaie chaque premier mot correspondant au début de la chaîne, puis on récurse sur le reste. Avec une chaîne comme "aaaaaaaaaab" et les mots a, aa, aaa, la récursion revisite les mêmes suffixes de nombreuses fois, d'où un temps exponentiel. La solution consiste à mémoriser la réponse pour chaque position de départ.
Approche 1 : descendante avec mémoïsation
On définit can(start) comme la possibilité de découper le suffixe commençant à start. On met le résultat en cache.
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
Chacune des n positions de départ est résolue une fois, et chacune essaie jusqu'à n positions de fin, avec un slice et une recherche dans un ensemble. Cela représente O(n au carré) recherches, ou O(n au cube) en travail sur les caractères si l'on compte le coût de construction de chaque slice. L'espace est en O(n) pour le cache et la récursion.
Approche 2 : programmation dynamique ascendante
Soit dp[i] vrai si les i premiers caractères peuvent être découpés. dp[0] est vrai, car le préfixe vide ne nécessite aucun mot. Pour chaque position de fin, on cherche une position de début où dp[start] est vrai et s[start:end] est un mot.
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
Limiter start aux max_len dernières positions est essentiel. Un mot du dictionnaire ne peut pas être plus long que le mot le plus long, donc cela ne sert à rien de vérifier des slices plus longs. Cela réduit la boucle interne à au plus L étapes, et l'ensemble à O(n fois L) recherches.
Trace
Pour s = "leetcode" avec ["leet","code"] : dp[0] est vrai. dp[4] devient vrai car dp[0] est vrai et "leet" est un mot. dp[8] devient vrai car dp[4] est vrai et "code" est un mot. La réponse est dp[8], qui est vrai.
Erreurs courantes
- Oublier que les mots peuvent être réutilisés.
- Renvoyer vrai dès qu'un préfixe est un mot. La chaîne entière doit être couverte.
- Construire chaque slice sans la limite max_len, ce qui est correct mais lent sur les chaînes longues.
- Convertir le dictionnaire en ensemble trop tard, ou pas du tout, ce qui fait que chaque recherche parcourt une liste.
Cas limites à tester
| Entrée | Attendu |
|---|---|
| La chaîne est elle-même un mot | true |
| Un mot est préfixe d'un autre ("a", "aa") | Géré par la DP, pas par une correspondance gloutonne |
| La chaîne contient une lettre absente de tous les mots | false |
| Le glouton échoue ("cars" avec "car", "ca", "rs") | true, en prenant ca + rs |
Comment l'expliquer en entretien
- Présentez la force brute et pourquoi elle répète le travail.
- Énoncez le sous-problème : le préfixe de longueur i peut-il être construit ?
- Écrivez la récurrence en mots, puis codez la version ascendante.
- Mentionnez la limite max_len et donnez la complexité.
- Proposez la version mémoïsée si l'interviewer préfère la récursion.
J'ai testé les deux versions ci-dessus contre une recherche par force brute sur 20 000 petites entrées aléatoires, plus les trois exemples du tableau, avant publication. Une vérification aléatoire rapide comme celle-ci est une bonne habitude à prendre en vous entraînant.
Exercices associés
Consultez notre aide-mémoire Big O pour les termes de complexité, la liste LeetCode Blind 75 pour savoir quoi pratiquer ensuite, et le guide de l'assistant d'entretien de codage pour vous entraîner.
Réfléchissez à voix haute pendant que vous codez. Une transcription montre si vous avez énoncé l'observation clé avant d'écrire. Respectez les règles de l'employeur concernant les outils d'IA lors de toute évaluation en direct.
Entraînez-vous aux entretiens de codage avec YesToTheOffer
Expliquez votre approche à voix haute, puis relisez votre transcription par la suite. 30 minutes gratuites, sans abonnement.