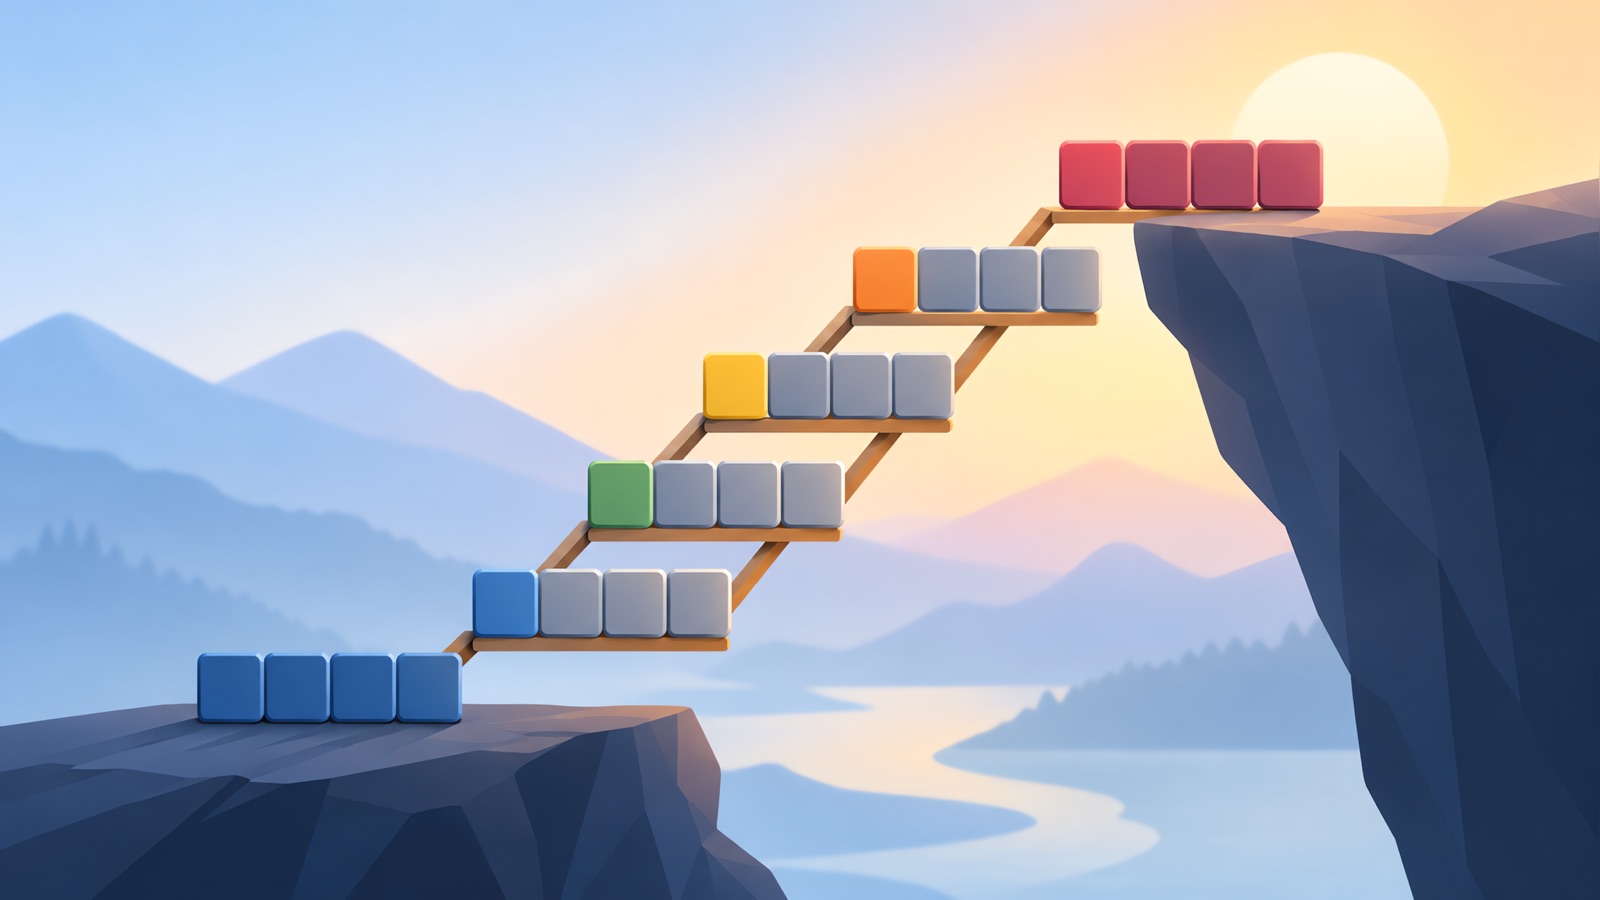
Word Ladder (LeetCode 127) demande la longueur de la plus courte chaîne d'un mot à un autre, en changeant une lettre à la fois, où chaque étape doit figurer dans une liste donnée. Chemin le plus court avec des étapes de coût égal : cela appelle une recherche en largeur. L'astuce qui la rend rapide consiste à regrouper les mots par motifs génériques comme h*t, pour éviter de comparer toutes les paires de mots.
Le problème
Étant donné beginWord, endWord et une liste de mots, renvoyez le nombre de mots de la plus courte séquence de transformation de beginWord à endWord, en comptant les deux extrémités. Chaque étape change exactement une lettre, et chaque mot vers lequel vous passez doit figurer dans la liste. Renvoyez 0 s'il n'existe aucune séquence de ce type.
| Entrée | Sortie | Pourquoi |
|---|---|---|
| hit vers cog, liste hot dot dog lot log cog | 5 | hit, hot, dot, dog, cog |
| hit vers cog, liste hot dot dog lot log | 0 | cog n'est pas dans la liste |
Pourquoi une recherche en largeur
Considérez chaque mot comme un nœud, avec une arête entre deux mots qui diffèrent d'une lettre. Chaque arête coûte une étape, donc la plus courte séquence est le plus court chemin dans un graphe non pondéré, et la recherche en largeur le trouve dès qu'elle atteint le mot d'arrivée.
Construction naïve des arêtes
Comparer toutes les paires de mots pour voir si elles diffèrent d'une lettre coûte O(N au carré fois L) pour N mots de longueur L. Avec des milliers de mots, c'est lent. Mieux vaut générer les voisins à partir de motifs.
Approche : les motifs génériques
Remplacez tour à tour chaque lettre par *. hot devient *ot, h*t et ho*. Deux mots sont voisins exactement lorsqu'ils partagent un motif. Construisez une table associant chaque motif aux mots qui lui correspondent, puis lancez la recherche à l'aide de cette table.
from collections import deque, defaultdict

def ladder_length(begin_word, end_word, word_list):
    words = set(word_list)
    if end_word not in words:
        return 0
    patterns = defaultdict(list)
    for w in words | {begin_word}:
        for i in range(len(w)):
            patterns[w[:i] + "*" + w[i + 1:]].append(w)
    queue = deque([(begin_word, 1)])
    seen = {begin_word}
    while queue:
        word, steps = queue.popleft()
        if word == end_word:
            return steps
        for i in range(len(word)):
            key = word[:i] + "*" + word[i + 1:]
            for nxt in patterns[key]:
                if nxt not in seen:
                    seen.add(nxt)
                    queue.append((nxt, steps + 1))
            patterns[key] = []
    return 0
Deux détails comptent. Le mot de départ est ajouté à la table des motifs même s'il n'est pas dans la liste, puisqu'on part de lui. Et une fois les mots d'un motif visités, patterns[key] = [] le vide pour que le même groupe ne soit pas reparcouru depuis chaque autre mot qui partage ce motif. Cela maintient le travail total linéaire en nombre de motifs.
Complexité
La construction des motifs prend O(N fois L), et chaque chaîne de motif coûte O(L) à construire, soit environ O(N fois L au carré) au total. La recherche touche chaque mot une fois et chaque groupe de motifs une fois, pour la même borne. L'espace est O(N fois L au carré) pour la table des motifs, puisque chaque mot est stocké sous L clés de longueur L.
Pour aller plus vite : la recherche bidirectionnelle
Lancez une recherche depuis le mot de départ et une depuis le mot d'arrivée, et développez toujours la plus petite frontière. Elles se rejoignent au milieu, donc chaque côté n'explore que la moitié de la profondeur. Cela vaut la peine d'être mentionné si l'intervieweur demande comment accélérer, et c'est plus de code que ce que la plupart des entretiens attendent de vous.
Erreurs fréquentes
- Renvoyer le nombre de modifications au lieu du nombre de mots. La séquence inclut beginWord, donc l'exemple donne 5, pas 4.
- Ne pas vérifier que endWord est dans la liste avant de lancer la recherche.
- Construire les voisins par comparaison deux à deux et dépasser le temps imparti.
- Laisser la recherche revisiter des mots, ce qui crée des boucles ou la ralentit.
- Utiliser un DFS, qui trouve un chemin mais pas le plus court.
Cas limites à tester
| Entrée | Attendu |
|---|---|
| endWord absent de la liste | 0 |
| Mots d'une seule lettre | Tout autre mot de la liste est à une étape |
| Mot d'arrivée à une étape du mot de départ | 2 |
| Mots sans aucune connexion | 0 |
Comment l'expliquer en entretien
- Reformulez le problème en graphe et expliquez pourquoi la recherche en largeur trouve le plus court chemin.
- Dites que la comparaison deux à deux est trop lente, puis introduisez les motifs génériques.
- Écrivez la table des motifs, la file et l'ensemble des mots visités.
- Précisez que vous comptez les mots, pas les modifications, et montrez le premier exemple.
- Donnez la complexité et mentionnez la recherche bidirectionnelle.
J'ai testé le code ci-dessus contre une recherche en largeur naïve par comparaison deux à deux sur 20 000 petites listes de mots aléatoires, ainsi que sur les deux exemples du tableau, avant publication. Une vérification aléatoire rapide comme celle-ci est une bonne habitude à prendre quand vous vous entraînez.
Pour s'entraîner
Consultez notre aide-mémoire Big O pour les termes de complexité, la liste LeetCode Blind 75 pour savoir quoi travailler ensuite, et le guide de l'assistant d'entretien de codage pour la méthode d'entraînement.
Déroulez votre raisonnement à voix haute pendant que vous codez. Une transcription montre si vous avez énoncé l'observation clé avant d'écrire. Respectez les règles de l'employeur concernant les outils d'IA lors de toute évaluation en direct.
Entraînez-vous aux entretiens de codage avec YesToTheOffer
Expliquez votre approche à voix haute, puis révisez votre transcription ensuite. 30 minutes gratuites, sans abonnement.