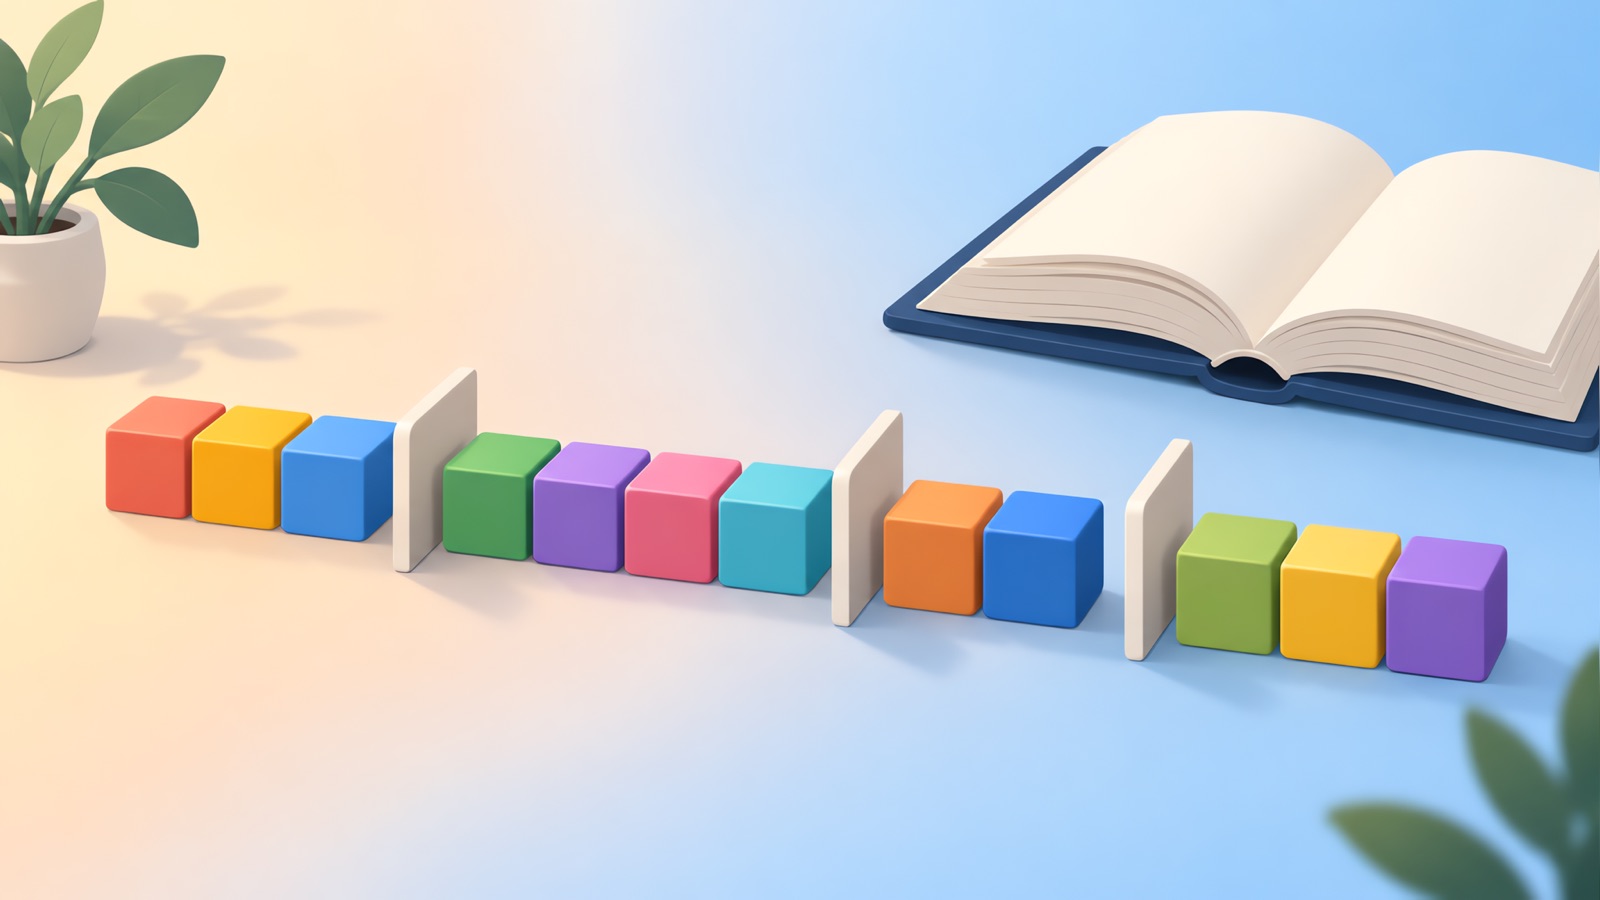
Word Break (LeetCode 139) plantea si una cadena se puede dividir en una secuencia de palabras que aparezcan todas en un diccionario. La solución limpia es programación dinámica sobre prefijos: un prefijo se puede formar si algún prefijo más corto que también se pueda formar va seguido de una palabra del diccionario. Se ejecuta en O(n por L), donde L es la palabra más larga, siempre que limites hasta dónde miras hacia atrás.
El problema
Dada una cadena s y una lista de palabras wordDict, devuelve true si s se puede dividir en una o más palabras del diccionario. Una palabra se puede reutilizar tantas veces como quieras.
| Entrada | Salida | Por qué |
|---|---|---|
| s = "leetcode", ["leet","code"] | true | leet + code |
| s = "applepenapple", ["apple","pen"] | true | apple + pen + apple |
| s = "catsandog", ["cats","dog","sand","and","cat"] | false | Ninguna división cubre las últimas letras |
Preguntas para el entrevistador: ¿el diccionario puede contener duplicados?, ¿puede estar vacío?, ¿se garantiza que la cadena no está vacía? (Revisa las restricciones en la página del problema).
Fuerza bruta
Prueba cada primera palabra que coincida con el inicio de la cadena y luego recurre sobre el resto. Con una cadena como "aaaaaaaaaab" y las palabras a, aa, aaa, la recursión vuelve a visitar los mismos sufijos muchas veces, así que el tiempo es exponencial. La solución es recordar la respuesta para cada posición de inicio.
Enfoque 1: top-down con memoización
Define can(start) como si el sufijo que empieza en start se puede dividir. Guarda el resultado en caché.
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
Cada una de las n posiciones de inicio se resuelve una vez, y cada una prueba hasta n posiciones de fin, con un slice y una búsqueda en el conjunto. Eso son O(n al cuadrado) búsquedas, u O(n al cubo) de trabajo sobre caracteres si cuentas el coste de construir cada slice. El espacio es O(n) para la caché y la recursión.
Enfoque 2: programación dinámica bottom-up
Sea dp[i] verdadero si los primeros i caracteres se pueden dividir. dp[0] es verdadero, ya que el prefijo vacío no necesita ninguna palabra. Para cada posición de fin, busca un inicio donde dp[start] sea verdadero y s[start:end] sea una palabra.
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
Limitar start a las últimas max_len posiciones es importante. Una palabra del diccionario no puede ser más larga que la palabra más larga, así que no tiene sentido comprobar slices más largos. Eso convierte el bucle interno en como mucho L pasos, y todo el algoritmo en O(n por L) búsquedas.
Traza
Para s = "leetcode" con ["leet","code"]: dp[0] es verdadero. dp[4] pasa a ser verdadero porque dp[0] es verdadero y "leet" es una palabra. dp[8] pasa a ser verdadero porque dp[4] es verdadero y "code" es una palabra. La respuesta es dp[8], que es verdadero.
Errores comunes
- Olvidar que las palabras se pueden reutilizar.
- Devolver true en cuanto algún prefijo es una palabra. Hay que cubrir toda la cadena.
- Construir todos los slices sin el límite max_len, lo cual es correcto pero lento en cadenas largas.
- Convertir el diccionario a un conjunto tarde, o no hacerlo, de modo que cada búsqueda recorre una lista.
Casos límite que probar
| Entrada | Esperado |
|---|---|
| La cadena es ella misma una palabra | true |
| Una palabra es prefijo de otra ("a", "aa") | Lo resuelve la DP, no una coincidencia voraz |
| La cadena tiene una letra que no está en ninguna palabra | false |
| La estrategia voraz falla ("cars" con "car", "ca", "rs") | true, tomando ca + rs |
Cómo explicarlo en una entrevista
- Menciona la fuerza bruta y por qué repite trabajo.
- Enuncia el subproblema: ¿se puede construir el prefijo de longitud i?
- Escribe la recurrencia con palabras y luego programa la versión bottom-up.
- Menciona el límite max_len y da la complejidad.
- Ofrece la versión con memoización si el entrevistador prefiere la recursión.
Probé ambas versiones de arriba contra una búsqueda de fuerza bruta con 20.000 entradas pequeñas aleatorias, además de los tres ejemplos de la tabla, antes de publicar. Una comprobación aleatoria rápida como esa es un buen hábito cuando practicas.
Práctica relacionada
Consulta nuestra chuleta de Big O para los términos de complejidad, la lista LeetCode Blind 75 para saber qué practicar después, y la guía del asistente para entrevistas de programación para saber cómo practicar.
Ve explicando tu enfoque en voz alta mientras programas. Una transcripción muestra si enunciaste la observación clave antes de escribir. Sigue las normas del empleador sobre herramientas de IA en cualquier evaluación en vivo.
Practica entrevistas de programación con YesToTheOffer
Explica tu enfoque en voz alta y luego revisa tu transcripción. 30 minutos gratis, sin suscripción.