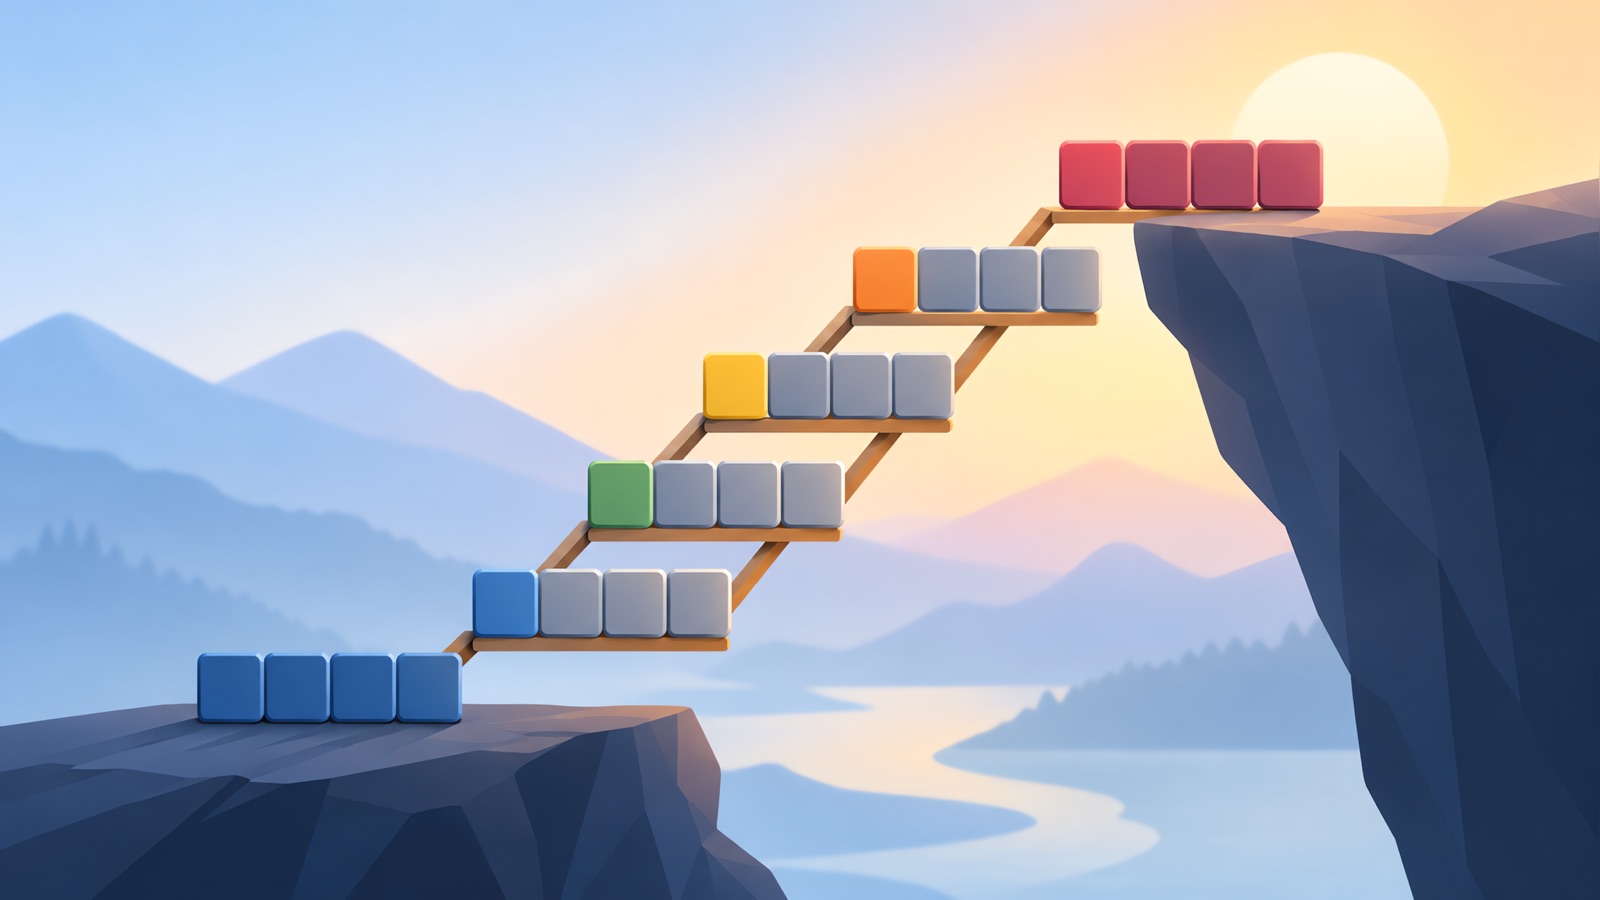
Word Ladder (LeetCode 127) pide la longitud de la cadena más corta de una palabra a otra, cambiando una letra a la vez, donde cada paso debe estar en una lista dada. Camino más corto con pasos iguales significa búsqueda en anchura. El truco que lo hace rápido es agrupar palabras por patrones comodín como h*t, para no comparar cada par de palabras.
El problema
Dados beginWord, endWord y una lista de palabras, devuelve el número de palabras en la secuencia de transformación más corta desde beginWord hasta endWord, contando ambos extremos. Cada paso cambia exactamente una letra, y cada palabra a la que avanzas debe estar en la lista. Devuelve 0 si no existe tal secuencia.
| Entrada | Salida | Por qué |
|---|---|---|
| hit a cog, lista hot dot dog lot log cog | 5 | hit, hot, dot, dog, cog |
| hit a cog, lista hot dot dog lot log | 0 | cog no está en la lista |
Por qué búsqueda en anchura
Trata cada palabra como un nodo, con una arista entre dos palabras que difieren en una letra. Cada arista cuesta un paso, así que la secuencia más corta es el camino más corto en un grafo no ponderado, y la búsqueda en anchura lo encuentra la primera vez que llega a la palabra final.
Construcción de aristas por fuerza bruta
Comparar cada par de palabras para ver si difieren en una letra cuesta O(N al cuadrado por L) para N palabras de longitud L. Con miles de palabras eso es lento. Mejor: genera vecinos a partir de patrones.
Enfoque: patrones comodín
Reemplaza cada letra por turnos con *. hot se convierte en *ot, h*t y ho*. Dos palabras son vecinas exactamente cuando comparten un patrón. Construye un mapa de patrón a las palabras que encajan con él, y luego ejecuta la búsqueda usándolo.
from collections import deque, defaultdict

def ladder_length(begin_word, end_word, word_list):
    words = set(word_list)
    if end_word not in words:
        return 0
    patterns = defaultdict(list)
    for w in words | {begin_word}:
        for i in range(len(w)):
            patterns[w[:i] + "*" + w[i + 1:]].append(w)
    queue = deque([(begin_word, 1)])
    seen = {begin_word}
    while queue:
        word, steps = queue.popleft()
        if word == end_word:
            return steps
        for i in range(len(word)):
            key = word[:i] + "*" + word[i + 1:]
            for nxt in patterns[key]:
                if nxt not in seen:
                    seen.add(nxt)
                    queue.append((nxt, steps + 1))
            patterns[key] = []
    return 0
Dos detalles importan. La palabra inicial se añade al mapa de patrones aunque no esté en la lista, ya que empiezas desde ella. Y después de visitar las palabras de un patrón, patterns[key] = [] lo vacía para que el mismo grupo no se vuelva a recorrer desde cada otra palabra que comparte el patrón. Eso mantiene el trabajo total lineal en el número de patrones.
Complejidad
Construir los patrones toma O(N por L), y cada cadena de patrón cuesta O(L) en construirse, así que en total es aproximadamente O(N por L al cuadrado). La búsqueda toca cada palabra una vez y cada grupo de patrones una vez, para la misma cota. El espacio es O(N por L al cuadrado) para el mapa de patrones, ya que cada palabra se almacena bajo L claves de longitud L.
Ir más rápido: búsqueda bidireccional
Ejecuta una búsqueda desde la palabra inicial y otra desde la palabra final, y expande siempre la frontera más pequeña. Se encuentran en el medio, así que cada lado solo busca la mitad de la profundidad. Vale la pena mencionarlo si el entrevistador pregunta cómo acelerarlo, y es más código del que la mayoría de las entrevistas esperan que escribas.
Errores comunes
- Devolver el número de cambios en lugar del número de palabras. La secuencia incluye beginWord, así que el ejemplo da 5, no 4.
- No comprobar que endWord está en la lista antes de buscar.
- Construir vecinos con una comparación por pares y agotar el tiempo.
- Dejar que la búsqueda vuelva a visitar palabras, lo que provoca bucles o la ralentiza.
- Usar DFS, que encuentra un camino pero no el más corto.
Casos límite que probar
| Entrada | Esperado |
|---|---|
| endWord ausente de la lista | 0 |
| Palabras de una letra | Cualquier otra palabra de la lista está a un paso |
| Palabra final a un paso de la inicial | 2 |
| Palabras sin conexión | 0 |
Cómo explicarlo en una entrevista
- Reformúlalo como un grafo y di por qué la búsqueda en anchura encuentra el camino más corto.
- Di que la comparación por pares es demasiado lenta e introduce los patrones comodín.
- Escribe el mapa de patrones, la cola y el conjunto de visitados.
- Di que cuentas palabras, no ediciones, y muestra el primer ejemplo.
- Da la complejidad y menciona la búsqueda bidireccional.
Probé el código de arriba contra una búsqueda en anchura simple por pares en 20.000 listas de palabras pequeñas aleatorias, además de los dos ejemplos de la tabla, antes de publicarlo. Una comprobación aleatoria rápida como esa es un buen hábito cuando practicas.
Práctica relacionada
Consulta nuestra chuleta de Big O para los términos de complejidad, la lista LeetCode Blind 75 para saber qué practicar después, y la guía del asistente para entrevistas de programación para saber cómo practicar.
Explica tu enfoque en voz alta mientras programas. Una transcripción muestra si enunciaste la observación clave antes de escribir. Sigue las reglas del empleador sobre herramientas de IA en cualquier evaluación en vivo.
Practica entrevistas de programación con YesToTheOffer
Explica tu enfoque en voz alta y luego revisa tu transcripción después. 30 minutos gratis, sin suscripción.