Kosarajus Algorithmus findet die starken Zusammenhangskomponenten (SCCs) eines gerichteten Graphen. Eine SCC ist eine Gruppe von Knoten, in der jeder Knoten jeden anderen erreichen kann. Der Algorithmus führt zwei Tiefensuchen durch: Die erste zeichnet die Reihenfolge auf, in der die Knoten fertig werden, und die zweite läuft auf dem Graphen mit umgekehrten Kanten und verarbeitet die Knoten in umgekehrter Fertigstellungsreihenfolge. Jeder Baum der zweiten Suche ist eine SCC. Der Algorithmus läuft in O(V + E) Zeit.
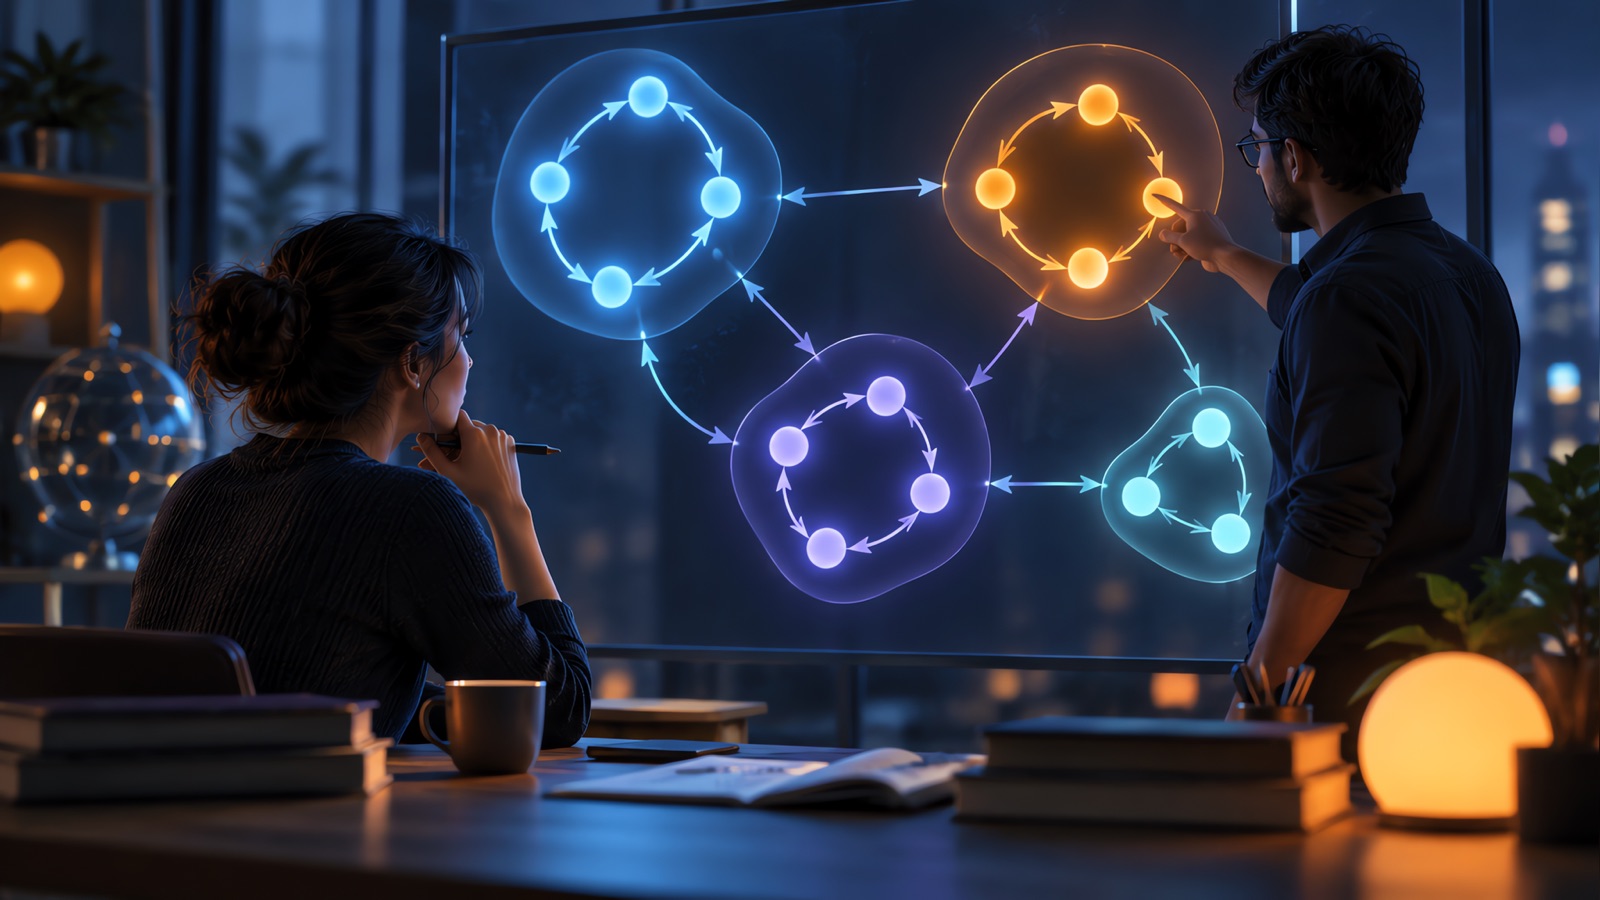
Wenn man jede SCC zu einem einzigen Knoten zusammenfasst, bleibt ein gerichteter Graph ohne Zyklen übrig. Deshalb tauchen SCCs in der Abhängigkeitsanalyse, der Deadlock-Erkennung, bei 2-SAT und in jedem Problem auf, bei dem Zyklen zuerst zusammengefasst werden müssen.
Die beiden Durchläufe, Schritt für Schritt
- Führe eine DFS über den gesamten Graphen aus. Wenn ein Knoten fertig wird (alle seine ausgehenden Nachbarn sind abgearbeitet), schiebe ihn auf eine Liste.
- Kehre jede Kante um, um den transponierten Graphen zu erhalten.
- Gehe die Fertigstellungsliste von hinten nach vorne durch. Für jeden noch nicht besuchten Knoten führe eine DFS auf dem transponierten Graphen aus. Alles, was diese Suche erreicht, ist eine SCC.
Beide Schleifen müssen bei jedem unbesuchten Knoten starten, nicht nur bei Knoten 0, weil der Graph nicht zusammenhängend sein muss.
Ein durchgerechnetes Beispiel
Nimm 8 Knoten und diese Kanten:
0 → 1, 1 → 2, 2 → 0      (cycle A: 0, 1, 2)
2 → 3
3 → 4, 4 → 5, 5 → 3      (cycle B: 3, 4, 5)
6 → 5
6 → 7, 7 → 6             (cycle C: 6, 7)
Die SCCs sollten 2, 5 und 7 sein.
Erster Durchlauf
Starte die DFS bei 0 und gehe 0 → 1 → 2 → 3 → 4 → 5. Knoten 5 hat kein neues Ziel mehr, also wird er zuerst fertig, dann 4, dann 3. Zurück bei 2 bleibt nichts übrig, also werden 2, 1 und 0 fertig. Knoten 6 wurde noch nicht besucht, also starte dort: 5 ist bereits abgearbeitet, also gehe zu 7, der fertig wird, dann 6. Die Fertigstellungsreihenfolge ist:
5, 4, 3, 2, 1, 0, 7, 6
Zweiter Durchlauf
Kehre jede Kante um und verarbeite die Knoten vom Ende dieser Liste: 6 zuerst. Im umgekehrten Graphen kann 6 nur 7 erreichen, also ist 7 die erste SCC. Der nächste unbesuchte Knoten ist 0, der im umgekehrten Graphen 2 und 1 erreicht, was 2 ergibt. Die Kante 2 → 3 zeigt jetzt 3 → 2, aber 2 ist bereits zugeordnet, also stoppt die Suche dort. Zuletzt erreicht 3 die Knoten 5 und 4, was 5 ergibt.
Warum es funktioniert
Stell dir den Graphen der SCCs vor (jede Komponente zu einem Knoten zusammengefasst), der keine Zyklen hat. Im ersten Durchlauf gehört der Knoten, der zuletzt fertig wird, immer zu einer „Quell“-Komponente, also einer ohne eingehende Kanten aus anderen nicht zugeordneten Komponenten. Das Umkehren der Kanten macht aus dieser Quelle eine Senke, sodass eine dort gestartete DFS ihre eigene Komponente nicht verlassen kann. Sobald diese Komponente entfernt ist, gilt dasselbe Argument für die nächste.
In einem Interview ist das meist das erwartete Beweisniveau: Die Fertigstellungsreihenfolge wählt eine sichere Startkomponente, und das Umkehren der Kanten verhindert, dass die zweite Suche in andere Komponenten abdriftet.
Python-Implementierung
Diese Version verwendet eine iterative DFS, sodass sie bei tiefen Graphen nicht an Pythons Rekursionslimit stößt.
from collections import defaultdict

def kosaraju(n, edges):
    graph = defaultdict(list)
    reverse = defaultdict(list)
    for u, v in edges:
        graph[u].append(v)
        reverse[v].append(u)

    # Pass 1: record vertices in the order they finish (iterative DFS)
    visited = [False] * n
    order = []
    for start in range(n):
        if visited[start]:
            continue
        visited[start] = True
        stack = [(start, iter(graph[start]))]
        while stack:
            node, neighbors = stack[-1]
            for nxt in neighbors:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append((nxt, iter(graph[nxt])))
                    break
            else:
                stack.pop()
                order.append(node)

    # Pass 2: DFS on the reversed graph, latest finish time first
    visited = [False] * n
    components = []
    for start in reversed(order):
        if visited[start]:
            continue
        visited[start] = True
        component = []
        stack = [start]
        while stack:
            node = stack.pop()
            component.append(node)
            for nxt in reverse[node]:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append(nxt)
        components.append(component)
    return components


edges = [(0, 1), (1, 2), (2, 0), (2, 3), (3, 4), (4, 5), (5, 3), (6, 5), (6, 7), (7, 6)]
print(kosaraju(8, edges))  # [[6, 7], [0, 2, 1], [3, 5, 4]]
Die Reihenfolge der Knoten innerhalb jeder Komponente hängt vom Traversal ab, also vergleiche Komponenten in deinen Tests als Mengen. Wir haben diese Implementierung gegen eine Brute-Force-Erreichbarkeitsprüfung auf 2.000 zufälligen Graphen getestet.
Komplexität
| Schritt | Zeit |
|---|---|
| Erste DFS | O(V + E) |
| Aufbau des umgekehrten Graphen | O(V + E) |
| Zweite DFS | O(V + E) |
| Gesamt | O(V + E) |
Der Speicherbedarf ist O(V + E) für die beiden Adjazenzlisten, plus O(V) für das visited-Array, die Fertigstellungsreihenfolge und den Stack.
Fehler, die es kaputt machen
Der häufigste Bug ist, Knoten aufzuzeichnen, wenn die DFS sie zum ersten Mal erreicht, statt wenn sie fertig werden. Weitere sind: vergessen, die Fertigstellungsreihenfolge für den zweiten Durchlauf umzukehren, den zweiten Durchlauf auf dem Originalgraphen statt auf dem umgekehrten laufen zu lassen, das visited-Array zwischen den Durchläufen nicht zurückzusetzen und nur bei Knoten 0 zu starten, sodass nicht zusammenhängende Teile übersprungen werden. Eine rekursive DFS kann bei langen Ketten außerdem den Stack überlaufen lassen, weshalb der obige Code iterativ ist.
Gute Testfälle: ein einzelner Knoten, ein Knoten mit einer Selbstschleife, ein großer Zyklus, eine Einbahnkette (jeder Knoten ist seine eigene SCC), zwei durch eine Kante verbundene Zyklen und ein nicht zusammenhängender Graph.
Kosaraju vs. Tarjan
Beide laufen in O(V + E). Kosaraju macht zwei Durchläufe und baut den umgekehrten Graphen, was ihn leichter zu erklären und korrekt umzusetzen macht. Tarjans Algorithmus erledigt es in einem Durchlauf ohne umgekehrten Graphen, verfolgt aber Discovery-Indizes und Low-Link-Werte auf einem Stack, was mehr Zustand ist, den man im Blick behalten muss. Im Interview nimm den, den du korrekt implementieren und erklären kannst. Wenn der Interviewer einen einzigen Durchlauf verlangt, ist das ein Hinweis auf Tarjan.
Graph-Probleme üben
Zeichne das obige Beispiel einmal von Hand nach, bevor du Code schreibst; die meisten Bugs zeigen sich als falsche Fertigstellungsreihenfolge. Verwandte Leitfäden: Floyd–Warshall für All-Pairs-Shortest-Paths, Bellman–Ford für Graphen mit negativen Kanten und unser Big-O-Cheat-Sheet. Wenn du YesToTheOffer beim Coding-Training nutzt, kann die Screenshot-Coding-Hilfe deinen Ansatz prüfen, und das Sitzungsprotokoll zeigt, ob du deine Argumentation klar erklärt hast.
Übe Coding-Interviews mit Feedback
Screenshot-Coding-Hilfe und ein Transkript Ihrer Übungssitzung. 30 kostenlose Minuten.