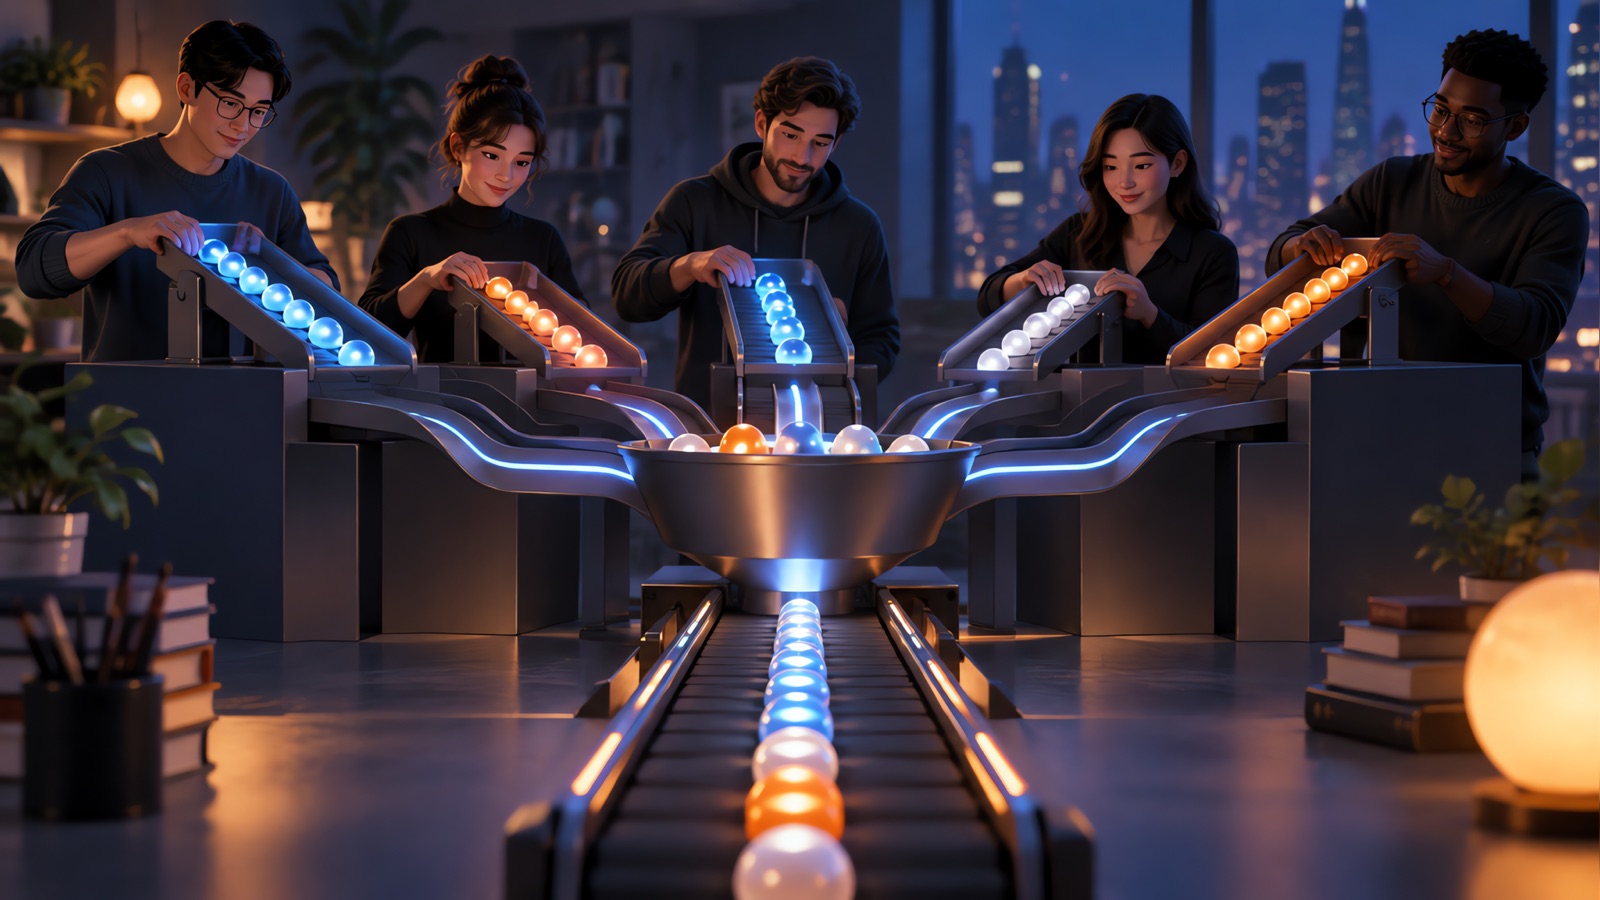
Merge k Sorted Lists (LeetCode 23) verlangt von dir, k sortierte verkettete Listen zu einer einzigen sortierten Liste zu verschmelzen. Die Aufgabe ist beliebt, weil die Brute-Force-Lösung offensichtlich ist und der interessante Teil darin besteht, zwischen zwei guten Wegen zu wählen, um es besser zu machen: einem Min-Heap oder Teile-und-herrsche. Beide laufen in O(N log k), wobei N die Gesamtzahl der Knoten ist.
Das Problem
Gegeben ist ein Array von k verketteten Listen, jede in aufsteigender Reihenfolge sortiert. Verschmelze sie zu einer einzigen sortierten verketteten Liste und gib sie zurück.
Beispiel: [[1,4,5],[1,3,4],[2,6]] wird zu [1,1,2,3,4,4,5,6].
Fragen, die du dem Interviewer stellen solltest:
- Kann das Array leer sein oder leere Listen enthalten? (Ja, beides behandeln.)
- Soll ich die vorhandenen Knoten wiederverwenden oder neue erstellen? (Wiederverwenden ist in Ordnung und spart Speicher.)
- Sind doppelte Werte möglich? (Ja, also halte die Zusammenführung stabil, falls das wichtig ist.)
Brute Force
Sammle alle Werte in einem Array, sortiere es und baue eine Liste neu auf. Die Zeit ist O(N log N) und der Speicher O(N). Es funktioniert, ignoriert aber, dass jede Liste bereits sortiert ist, deshalb wird es selten als endgültige Antwort akzeptiert.
Ansatz 1: ein Min-Heap
Behalte einen Zeiger pro Liste. Der nächste Knoten in der Ausgabe ist immer der kleinste unter den aktuellen Köpfen, also halte die Köpfe in einem Min-Heap.
- Schiebe den Kopf jeder nicht leeren Liste auf den Heap.
- Hole den kleinsten heraus, hänge ihn an das Ergebnis an und schiebe seinen nächsten Knoten darauf, falls es einen gibt.
- Wiederhole das, bis der Heap leer ist.
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
Der Index i dient als Tiebreaker. Ohne ihn würden zwei Einträge mit gleichen Werten Python dazu bringen, ListNode-Objekte zu vergleichen, was einen TypeError auslöst.
Komplexität: Jeder der N Knoten kommt einmal in den Heap und einmal heraus, und jede Operation kostet O(log k), also ist die Zeit O(N log k). Der Heap enthält höchstens k Knoten, also ist der zusätzliche Speicher O(k).
Ansatz 2: Teile und herrsche
Zwei sortierte Listen zu verschmelzen ist einfach und dauert O(n) Zeit. Verschmelze die Listen paarweise, dann die Ergebnisse paarweise, und so weiter, wie in einem Turnier.
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
Komplexität: Es gibt etwa log k Runden, und jede Runde berührt alle N Knoten einmal, also ist die Zeit O(N log k). Die Schleifenversion braucht nur O(1) zusätzlichen Speicher abgesehen von der Liste der Köpfe.
Warum nicht eins nach dem anderen verschmelzen?
Liste 1 mit Liste 2 zu verschmelzen, dann das Ergebnis mit Liste 3, und so weiter, wirkt natürlich, kostet aber mehr. Die erste Liste wird durch k Zusammenführungen geschleppt. Wenn jede Liste n Knoten hat, ist der Gesamtaufwand etwa n x (1 + 2 + ... + k), also O(n k zum Quadrat). Listen paarweise zu kombinieren hält die Größen ausgeglichen, sodass jeder Knoten etwa log k Mal berührt wird.
Die beiden im Vergleich
| Min-Heap | Teile und herrsche | |
|---|---|---|
| Zeit | O(N log k) | O(N log k) |
| Zusätzlicher Speicher | O(k) | O(1) mit der Schleifenversion |
| Code | Kurz, braucht einen Tiebreaker | Verwendet merge_two wieder |
| Gut wenn | Listen als Streams ankommen oder du nur die ersten paar Ergebnisse brauchst | Du alle Listen im Speicher hast |
Wenn ein Interviewer sagt, die Listen seien zu groß für den Speicher und kämen als Streams an, lässt sich der Heap-Ansatz natürlich erweitern, da er nur den aktuellen Kopf jedes Streams benötigt.
Randfälle zum Testen
| Eingabe | Erwartet |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| Eine nicht leere Liste | Diese Liste |
| Doppelte Werte über Listen hinweg | Alle bleiben erhalten, in Reihenfolge |
| Negative Zahlen | Werden genauso behandelt |
| Sehr ungleiche Längen | Werden behandelt, da die verbleibende Liste am Ende angehängt wird |
Wie du es im Interview erklärst
- Nenne die Brute-Force-Lösung und warum sie verschwenderisch ist.
- Sage die entscheidende Beobachtung: Der nächste Ausgabeknoten ist der kleinste aktuelle Kopf.
- Wähle den Heap, schreibe ihn und erwähne den Tiebreaker.
- Nenne die Komplexität: O(N log k) Zeit und O(k) Speicher.
- Biete Teile und herrsche als die O(1)-Speicher-Alternative an.
- Teste mit einer leeren Eingabe und einer mit Duplikaten.
Ich habe beide Versionen oben gegen eine sortierungsbasierte Prüfung mit 3.000 zufälligen Eingaben getestet, einschließlich leerer Listen, bevor ich das veröffentlicht habe. So eine schnelle Zufallsprüfung ist eine gute Angewohnheit beim Üben.
Verwandte Übungen
Wenn das einfach war, versuche zuerst Merge Two Sorted Lists, dann Sort List und Find Median from Data Stream, die dieselben Ideen verwenden. Sieh dir unseren Big-O-Spickzettel für die Komplexitätsbegriffe an, den Leitfaden zum längsten gemeinsamen Teilstring für dynamische Programmierung und den Leitfaden zum Coding-Interview-Assistenten für das Üben.
Sprich deinen Ansatz laut durch, während du codest. Ein Mock-Interview-Transkript zeigt, ob du die entscheidende Beobachtung erklärt hast, bevor du geschrieben hast. Befolge die Regeln des Arbeitgebers zu KI-Tools in jeder Live-Bewertung.
Übe Coding-Interviews mit YesToTheOffer
Führe ein Mock-Coding-Interview durch, erkläre deinen Ansatz laut und überprüfe anschließend dein Transkript. 30 kostenlose Minuten, kein Abonnement.