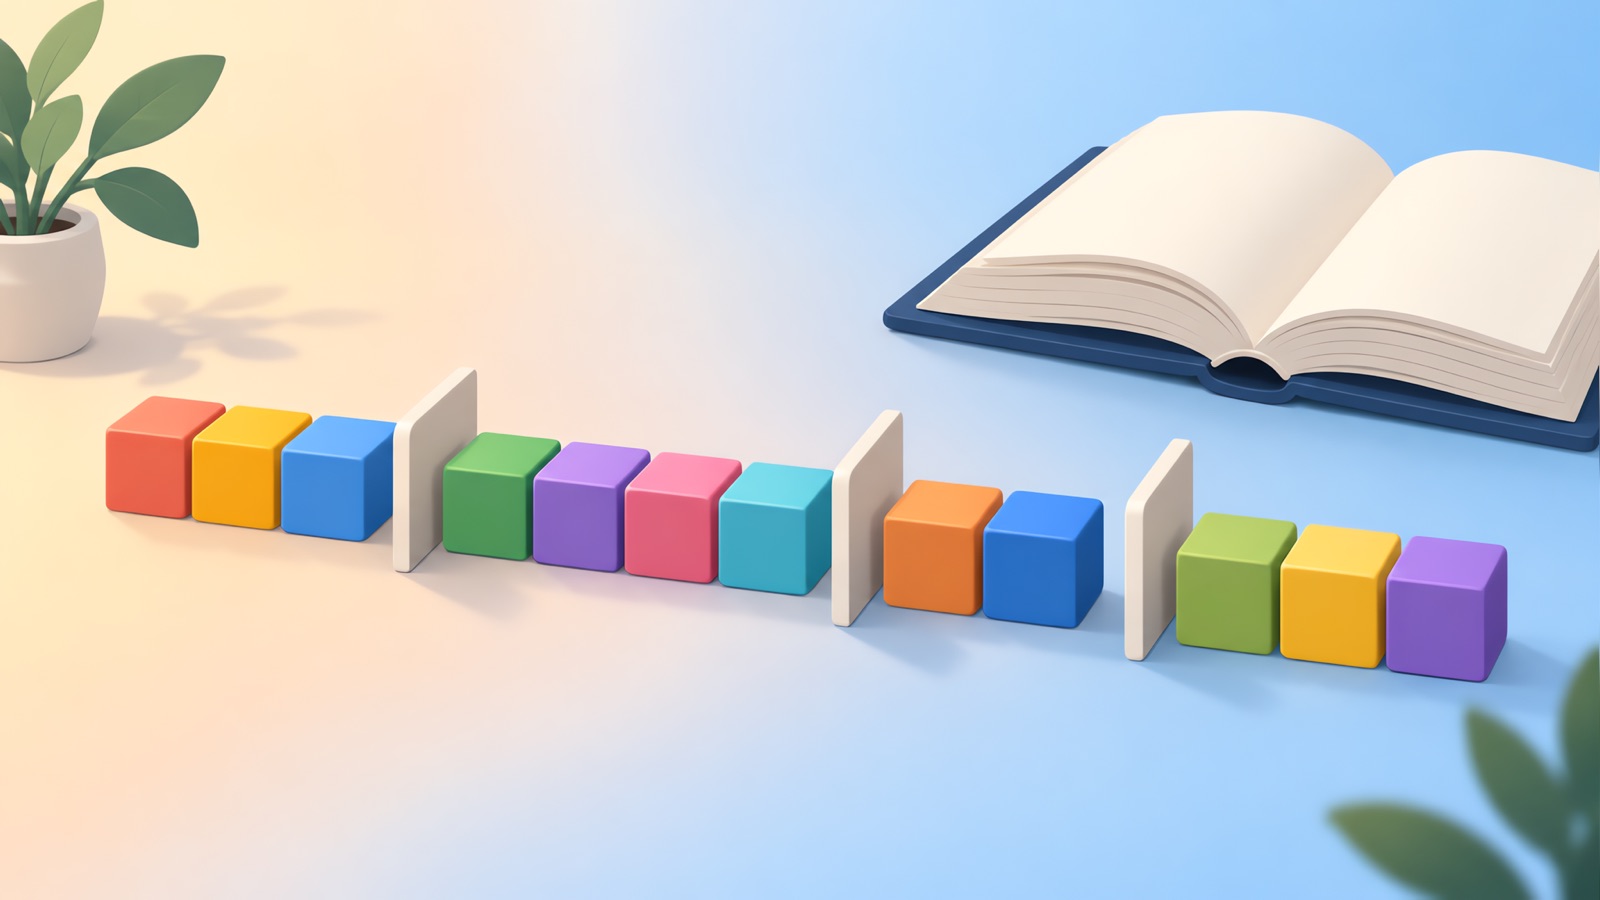
O problema Word Break (LeetCode 139) pergunta se uma string pode ser dividida em uma sequência de palavras que aparecem todas em um dicionário. A resposta limpa é programação dinâmica sobre prefixos: um prefixo pode ser formado se algum prefixo menor e formável for seguido por uma palavra do dicionário. Roda em O(n vezes L), onde L é a palavra mais longa, depois que você limita até onde olhar para trás.
O problema
Dada uma string s e uma lista de palavras wordDict, retorne true se s puder ser dividida em uma ou mais palavras do dicionário. Uma palavra pode ser reutilizada quantas vezes você quiser.
| Entrada | Saída | Por quê |
|---|---|---|
| s = "leetcode", ["leet","code"] | true | leet + code |
| s = "applepenapple", ["apple","pen"] | true | apple + pen + apple |
| s = "catsandog", ["cats","dog","sand","and","cat"] | false | Nenhuma divisão cobre as últimas letras |
Perguntas para fazer ao entrevistador: o dicionário pode conter duplicatas, pode estar vazio, e a string tem garantia de não ser vazia? (Confira as restrições na página do problema.)
Força bruta
Tente cada primeira palavra que casa com o início da string, depois recorra no restante. Com uma string como "aaaaaaaaaab" e as palavras a, aa, aaa, a recursão revisita os mesmos sufixos muitas vezes, então o tempo é exponencial. A correção é memorizar a resposta para cada posição inicial.
Abordagem 1: top-down com memoização
Defina can(start) como se o sufixo que começa em start pode ser dividido. Guarde o resultado em cache.
from functools import lru_cache

def word_break_memo(s, word_dict):
    words = set(word_dict)

    @lru_cache(maxsize=None)
    def can(start):
        if start == len(s):
            return True
        for end in range(start + 1, len(s) + 1):
            if s[start:end] in words and can(end):
                return True
        return False

    return can(0)
Cada uma das n posições iniciais é resolvida uma vez, e cada uma tenta até n posições finais, com um slice e uma busca no set. Isso dá O(n ao quadrado) buscas, ou O(n ao cubo) de trabalho com caracteres se você contar o custo de montar cada slice. O espaço é O(n) para o cache e a recursão.
Abordagem 2: programação dinâmica bottom-up
Seja dp[i] verdadeiro se os primeiros i caracteres podem ser divididos. dp[0] é verdadeiro, já que o prefixo vazio não precisa de palavras. Para cada posição final, procure um início onde dp[start] é verdadeiro e s[start:end] é uma palavra.
def word_break(s, word_dict):
    words = set(word_dict)
    max_len = max((len(w) for w in words), default=0)
    dp = [False] * (len(s) + 1)
    dp[0] = True
    for end in range(1, len(s) + 1):
        for start in range(max(0, end - max_len), end):
            if dp[start] and s[start:end] in words:
                dp[end] = True
                break
    return dp[len(s)]
Limitar start às últimas max_len posições faz diferença. Uma palavra do dicionário não pode ser maior que a palavra mais longa, então não faz sentido checar slices mais longos. Isso transforma o laço interno em no máximo L passos, e o todo em O(n vezes L) buscas.
Traço
Para s = "leetcode" com ["leet","code"]: dp[0] é verdadeiro. dp[4] vira verdadeiro porque dp[0] é verdadeiro e "leet" é uma palavra. dp[8] vira verdadeiro porque dp[4] é verdadeiro e "code" é uma palavra. A resposta é dp[8], que é verdadeiro.
Erros comuns
- Esquecer que as palavras podem ser reutilizadas.
- Retornar true assim que qualquer prefixo é uma palavra. A string inteira precisa ser coberta.
- Montar todos os slices sem o limite de max_len, o que é correto mas lento em strings longas.
- Converter o dicionário para um set tarde, ou não converter, de modo que cada busca percorre uma lista.
Casos de borda para testar
| Entrada | Esperado |
|---|---|
| A string já é uma palavra | true |
| Uma palavra é prefixo de outra ("a", "aa") | Tratado pela DP, não por casamento guloso |
| A string tem uma letra que nenhuma palavra contém | false |
| O guloso falha ("cars" com "car", "ca", "rs") | true, pegando ca + rs |
Como explicar na entrevista
- Diga a força bruta e por que ela repete trabalho.
- Enuncie o subproblema: o prefixo de comprimento i pode ser formado?
- Escreva a recorrência em palavras, depois codifique a versão bottom-up.
- Mencione o limite de max_len e dê a complexidade.
- Ofereça a versão com memoização se o entrevistador preferir recursão.
Testei as duas versões acima contra uma busca por força bruta em 20.000 entradas pequenas aleatórias, além dos três exemplos da tabela, antes de publicar. Uma checagem aleatória rápida como essa é um bom hábito na hora de praticar.
Prática relacionada
Veja nosso Big O cheat sheet para os termos de complexidade, a lista LeetCode Blind 75 para o que praticar em seguida, e o guia do assistente de entrevista de programação para saber como praticar.
Fale sobre sua abordagem em voz alta enquanto programa. Uma transcrição mostra se você enunciou a observação-chave antes de escrever. Siga as regras da empresa sobre ferramentas de IA em qualquer avaliação ao vivo.
Pratique entrevistas de programação com YesToTheOffer
Explique sua abordagem em voz alta e depois revise sua transcrição. 30 minutos grátis, sem assinatura.