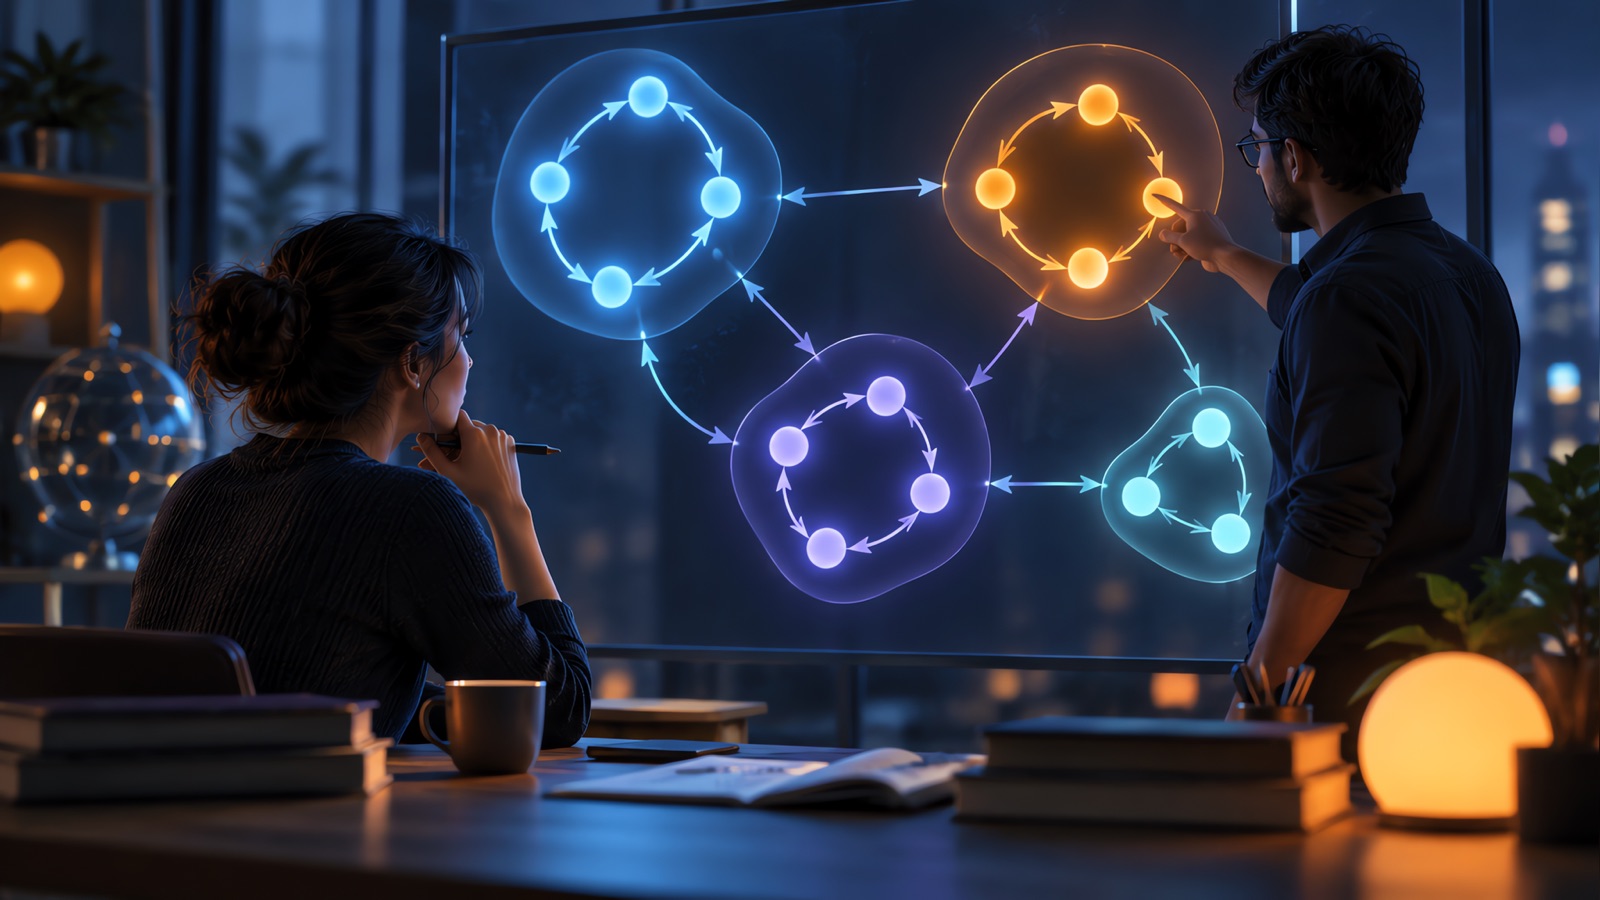
Kosaraju 알고리즘은 방향 그래프의 강한 연결 요소(SCC)를 찾는 알고리즘입니다. SCC란 모든 정점이 서로에게 도달할 수 있는 정점 그룹을 말합니다. 이 알고리즘은 두 번의 깊이 우선 탐색을 실행합니다. 첫 번째 탐색은 각 정점이 탐색을 마치는 순서를 기록하고, 두 번째 탐색은 모든 간선을 뒤집은 그래프에서 정점을 탐색 완료의 역순으로 처리합니다. 두 번째 탐색에서 만들어지는 각 트리가 하나의 SCC입니다. 시간 복잡도는 O(V + E)입니다.
각 SCC를 하나의 노드로 압축하면 사이클이 없는 방향 그래프가 남습니다. 그래서 SCC는 의존성 분석, 교착 상태 탐지, 2-SAT, 그리고 사이클을 먼저 합쳐야 하는 모든 문제에서 등장합니다.
두 번의 탐색, 단계별로
- 전체 그래프에 대해 DFS를 실행합니다. 정점이 탐색을 마치면(나가는 모든 이웃을 처리하면) 리스트에 추가합니다.
- 모든 간선을 뒤집어 전치 그래프를 만듭니다.
- 탐색 완료 리스트를 마지막부터 처음까지 순회합니다. 아직 방문하지 않은 정점마다 전치 그래프에서 DFS를 실행합니다. 그 탐색이 도달하는 모든 정점이 하나의 SCC입니다.
그래프가 연결되어 있지 않을 수 있으므로 두 반복 모두 정점 0에서만이 아니라 방문하지 않은 모든 정점에서 시작해야 합니다.
예제로 따라가기
8개의 정점과 다음 간선들이 있다고 합시다:
0 → 1, 1 → 2, 2 → 0      (cycle A: 0, 1, 2)
2 → 3
3 → 4, 4 → 5, 5 → 3      (cycle B: 3, 4, 5)
6 → 5
6 → 7, 7 → 6             (cycle C: 6, 7)
SCC는 2, 5, 7이 되어야 합니다.
첫 번째 탐색
0에서 DFS를 시작해 0 → 1 → 2 → 3 → 4 → 5로 갑니다. 정점 5는 새로 갈 곳이 없으므로 가장 먼저 탐색을 마치고, 그다음 4, 그다음 3이 마칩니다. 2로 돌아오면 남은 게 없으므로 2, 1, 0이 차례로 마칩니다. 정점 6은 아직 방문하지 않았으므로 거기서 시작합니다. 5는 이미 처리되었으니 7로 가고, 7이 마친 뒤 6이 마칩니다. 탐색 완료 순서는 다음과 같습니다:
5, 4, 3, 2, 1, 0, 7, 6
두 번째 탐색
모든 간선을 뒤집고 그 리스트의 끝에서부터 정점을 처리합니다. 먼저 6입니다. 뒤집힌 그래프에서 6은 7에만 도달할 수 있으므로 7이 첫 번째 SCC입니다. 다음으로 방문하지 않은 정점은 0이고, 뒤집힌 그래프에서 2와 1에 도달하므로 2가 됩니다. 간선 2 → 3은 이제 3 → 2를 가리키지만 2는 이미 배정되었으므로 탐색은 거기서 멈춥니다. 마지막으로 3은 5와 4에 도달해 5가 됩니다.
왜 동작하는가
SCC들로 이루어진 그래프(각 요소를 하나의 노드로 압축한 것)를 생각해 보면 사이클이 없습니다. 첫 번째 탐색에서 가장 마지막에 탐색을 마치는 정점은 항상 "소스" 요소, 즉 다른 미배정 요소로부터 들어오는 간선이 없는 요소에 속합니다. 간선을 뒤집으면 그 소스가 싱크가 되므로, 거기서 시작한 DFS는 자기 요소를 벗어날 수 없습니다. 그 요소를 제거하면 같은 논리가 다음 요소에도 적용됩니다.
면접에서는 보통 이 정도 수준의 증명을 기대합니다. 탐색 완료 순서가 안전한 시작 요소를 골라 주고, 간선을 뒤집으면 두 번째 탐색이 다른 요소로 새어 나가지 않는다는 것입니다.
Python 구현
이 버전은 반복적 DFS를 사용하므로 깊은 그래프에서도 Python의 재귀 한도에 걸리지 않습니다.
from collections import defaultdict

def kosaraju(n, edges):
    graph = defaultdict(list)
    reverse = defaultdict(list)
    for u, v in edges:
        graph[u].append(v)
        reverse[v].append(u)

    # Pass 1: record vertices in the order they finish (iterative DFS)
    visited = [False] * n
    order = []
    for start in range(n):
        if visited[start]:
            continue
        visited[start] = True
        stack = [(start, iter(graph[start]))]
        while stack:
            node, neighbors = stack[-1]
            for nxt in neighbors:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append((nxt, iter(graph[nxt])))
                    break
            else:
                stack.pop()
                order.append(node)

    # Pass 2: DFS on the reversed graph, latest finish time first
    visited = [False] * n
    components = []
    for start in reversed(order):
        if visited[start]:
            continue
        visited[start] = True
        component = []
        stack = [start]
        while stack:
            node = stack.pop()
            component.append(node)
            for nxt in reverse[node]:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append(nxt)
        components.append(component)
    return components


edges = [(0, 1), (1, 2), (2, 0), (2, 3), (3, 4), (4, 5), (5, 3), (6, 5), (6, 7), (7, 6)]
print(kosaraju(8, edges))  # [[6, 7], [0, 2, 1], [3, 5, 4]]
각 요소 안에서 정점의 순서는 탐색 방식에 따라 달라지므로 테스트에서는 요소를 집합으로 비교하세요. 이 구현은 2,000개의 무작위 그래프에 대해 완전 탐색 도달 가능성 검사와 대조해 검증했습니다.
복잡도
| 단계 | 시간 |
|---|---|
| 첫 번째 DFS | O(V + E) |
| 뒤집힌 그래프 만들기 | O(V + E) |
| 두 번째 DFS | O(V + E) |
| 합계 | O(V + E) |
공간은 두 개의 인접 리스트에 O(V + E), 그리고 방문 배열, 탐색 완료 순서, 스택에 O(V)가 필요합니다.
알고리즘을 망가뜨리는 실수들
가장 흔한 버그는 DFS가 정점에 처음 도달했을 때 기록하는 것입니다. 탐색을 마칠 때가 아니라요. 다른 실수로는 두 번째 탐색을 위해 탐색 완료 순서를 뒤집는 것을 잊는 것, 두 번째 탐색을 뒤집힌 그래프가 아니라 원래 그래프에서 실행하는 것, 두 탐색 사이에 방문 배열을 초기화하지 않는 것, 정점 0에서만 시작해 연결되지 않은 부분을 건너뛰는 것이 있습니다. 재귀적 DFS는 긴 체인에서 스택이 넘칠 수도 있는데, 그래서 위 코드는 반복적 방식입니다.
좋은 테스트 케이스로는 정점 하나, 자기 루프가 있는 정점, 하나의 큰 사이클, 한 방향 체인(모든 정점이 각자 자신의 SCC), 간선 하나로 연결된 두 사이클, 연결되지 않은 그래프가 있습니다.
Kosaraju vs. Tarjan
둘 다 O(V + E)로 실행됩니다. Kosaraju는 두 번의 탐색을 하고 뒤집힌 그래프를 만들어서 설명하기도, 정확히 구현하기도 더 쉽습니다. Tarjan 알고리즘은 뒤집힌 그래프 없이 한 번의 탐색으로 처리하지만, 스택 위에서 발견 인덱스와 로우링크 값을 추적해야 하므로 관리할 상태가 더 많습니다. 면접에서는 정확히 구현하고 설명할 수 있는 쪽을 쓰세요. 면접관이 한 번의 탐색을 요구한다면 그건 Tarjan을 쓰라는 신호입니다.
그래프 문제 연습하기
코드를 작성하기 전에 위 예제를 한 번 손으로 따라가 보세요. 대부분의 버그는 잘못된 탐색 완료 순서로 나타납니다. 관련 가이드: 모든 쌍 최단 경로를 위한 Floyd–Warshall, 음수 간선이 있는 그래프를 위한 Bellman–Ford, 그리고 Big O 치트 시트가 있습니다. 코딩 연습에 YesToTheOffer를 사용한다면, 스크린샷 코딩 도움이 접근 방식을 점검해 주고, 세션 기록을 통해 추론을 명확하게 설명했는지 확인할 수 있습니다.
피드백과 함께 코딩 인터뷰 연습하기
코딩 도움 스크린샷과 연습 세션의 기록. 30분 무료.