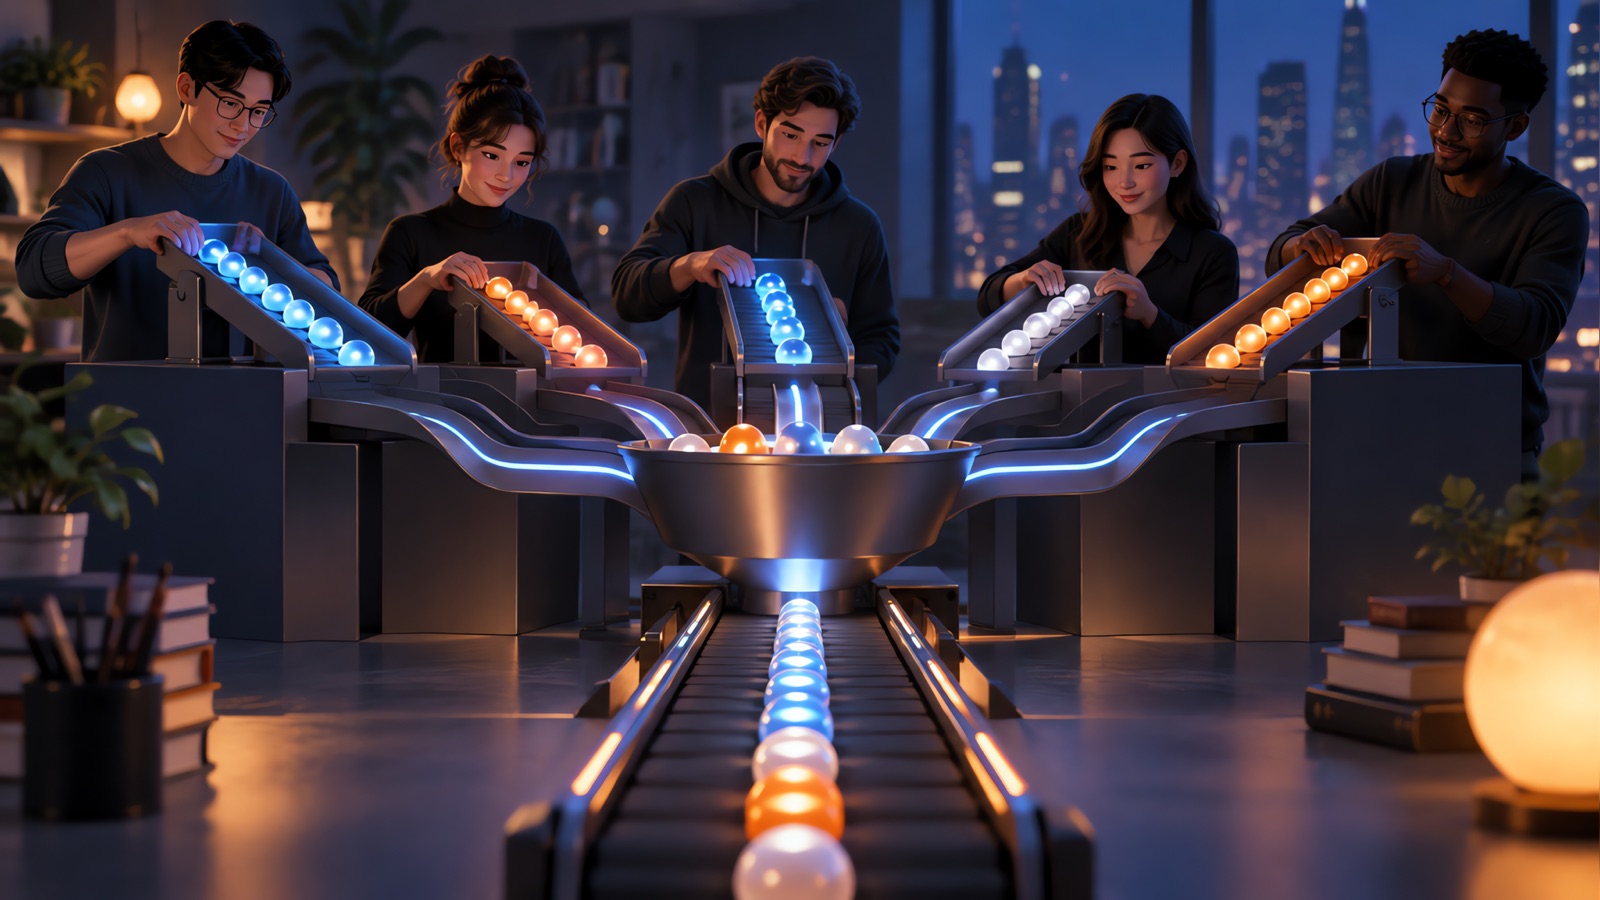
Merge k Sorted Lists (LeetCode 23)는 k개의 정렬된 연결 리스트를 하나의 정렬된 리스트로 합치는 문제입니다. 이 문제가 인기 있는 이유는 완전 탐색 방식이 너무 뻔하고, 흥미로운 부분은 더 나은 성능을 내는 두 가지 좋은 방법 중 하나를 고르는 데 있기 때문입니다. 바로 최소 힙(min-heap)과 분할 정복(divide and conquer)입니다. 둘 다 O(N log k) 시간에 실행되며, 여기서 N은 전체 노드 수입니다.
문제
오름차순으로 정렬된 k개의 연결 리스트 배열이 주어질 때, 이들을 하나의 정렬된 연결 리스트로 합쳐서 반환하세요.
예시: [[1,4,5],[1,3,4],[2,6]]는 [1,1,2,3,4,4,5,6]이 됩니다.
면접관에게 물어볼 질문:
- 배열이 비어 있을 수 있나요, 아니면 빈 리스트를 포함할 수 있나요? (네, 둘 다 처리해야 합니다.)
- 기존 노드를 재사용해야 하나요, 아니면 새로 만들어야 하나요? (재사용해도 괜찮고 메모리도 절약됩니다.)
- 중복 값이 가능한가요? (네, 그래서 안정성이 중요하다면 병합을 안정적으로 유지해야 합니다.)
완전 탐색
모든 값을 배열에 모아 정렬한 뒤 리스트를 다시 만듭니다. 시간은 O(N log N), 공간은 O(N)입니다. 동작은 하지만 각 리스트가 이미 정렬되어 있다는 점을 무시하기 때문에 최종 답안으로 인정받기는 어렵습니다.
접근법 1: 최소 힙
리스트마다 포인터를 하나씩 유지합니다. 출력의 다음 노드는 항상 현재 헤드 중 가장 작은 값이므로, 헤드들을 최소 힙에 넣어 관리합니다.
- 비어 있지 않은 각 리스트의 헤드를 힙에 넣습니다.
- 가장 작은 값을 꺼내 결과에 붙이고, 다음 노드가 있으면 힙에 넣습니다.
- 힙이 빌 때까지 반복합니다.
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
인덱스 i는 동점 처리를 위한 것입니다. 이게 없으면 값이 같은 두 항목을 비교할 때 Python이 ListNode 객체를 비교하게 되어 TypeError가 발생합니다.
복잡도: N개의 노드 각각이 힙에 한 번 들어가고 한 번 나오며, 각 연산은 O(log k)이므로 시간은 O(N log k)입니다. 힙에는 최대 k개의 노드만 들어가므로 추가 공간은 O(k)입니다.
접근법 2: 분할 정복
정렬된 두 리스트를 합치는 것은 간단하고 O(n) 시간이 걸립니다. 리스트를 쌍으로 합치고, 그 결과를 다시 쌍으로 합치는 식으로 토너먼트처럼 진행합니다.
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
복잡도: 약 log k번의 라운드가 있고, 각 라운드에서 모든 N개 노드를 한 번씩 처리하므로 시간은 O(N log k)입니다. 반복문 버전은 헤드 목록을 제외하면 O(1)의 추가 공간만 필요합니다.
왜 하나씩 합치면 안 되나요?
리스트 1과 리스트 2를 합치고, 그 결과를 리스트 3과 합치는 식은 자연스러워 보이지만 비용이 더 많이 듭니다. 첫 번째 리스트는 k번의 병합을 거치며 계속 복사됩니다. 모든 리스트에 n개의 노드가 있다면 총 작업량은 약 n x (1 + 2 + ... + k)로, O(n k 제곱)입니다. 리스트를 쌍으로 묶으면 크기가 균형을 유지하므로 각 노드는 약 log k번만 처리됩니다.
두 방법 비교
| 최소 힙 | 분할 정복 | |
|---|---|---|
| 시간 | O(N log k) | O(N log k) |
| 추가 공간 | O(k) | 반복문 버전은 O(1) |
| 코드 | 짧지만 동점 처리 필요 | merge_two 재사용 |
| 유리한 경우 | 리스트가 스트림으로 들어오거나 처음 몇 개 결과만 필요할 때 | 모든 리스트가 메모리에 있을 때 |
면접관이 리스트가 메모리에 담기엔 너무 크고 스트림으로 들어온다고 하면, 힙 방식이 자연스럽게 확장됩니다. 각 스트림의 현재 헤드만 있으면 되기 때문입니다.
테스트할 엣지 케이스
| 입력 | 예상 결과 |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| 비어 있지 않은 리스트 하나 | 그 리스트 |
| 리스트 간 중복 값 | 모두 순서대로 유지 |
| 음수 | 동일하게 처리 |
| 길이가 매우 다른 경우 | 남은 리스트가 끝에 붙으므로 처리됨 |
면접에서 설명하는 방법
- 완전 탐색 방식을 말하고 왜 비효율적인지 설명합니다.
- 핵심 관찰을 말합니다: 다음 출력 노드는 현재 헤드 중 가장 작은 값입니다.
- 힙을 선택하고 코드를 작성한 뒤 동점 처리에 대해 언급합니다.
- 복잡도를 말합니다: 시간 O(N log k), 공간 O(k).
- 분할 정복을 O(1) 공간 대안으로 제시합니다.
- 빈 입력과 중복이 있는 입력으로 테스트합니다.
저는 위의 두 버전을 게시하기 전에 빈 리스트를 포함한 3,000개의 무작위 입력에 대해 정렬 기반 검증과 비교 테스트했습니다. 이렇게 간단한 무작위 검증을 해보는 것은 연습할 때 좋은 습관입니다.
관련 연습
이게 쉬웠다면 Merge Two Sorted Lists를 먼저 풀어보고, 같은 아이디어를 사용하는 Sort List와 Find Median from Data Stream에 도전해 보세요. 복잡도 용어는 Big O 치트 시트를, 동적 프로그래밍은 최장 공통 부분 문자열 가이드를, 연습 방법은 코딩 면접 도우미 가이드를 참고하세요.
코드를 작성하면서 접근 방식을 소리 내어 설명하세요. 모의 면접 스크립트를 보면 코드를 작성하기 전에 핵심 관찰을 설명했는지 확인할 수 있습니다. 실시간 평가에서는 AI 도구에 관한 회사 규칙을 따르세요.
YesToTheOffer와 함께 코딩 인터뷰를 연습하세요
모의 코딩 인터뷰를 진행하고, 접근 방식을 소리 내어 설명하고, 이후에 녹취록을 검토하세요. 30분 무료, 구독 없음.