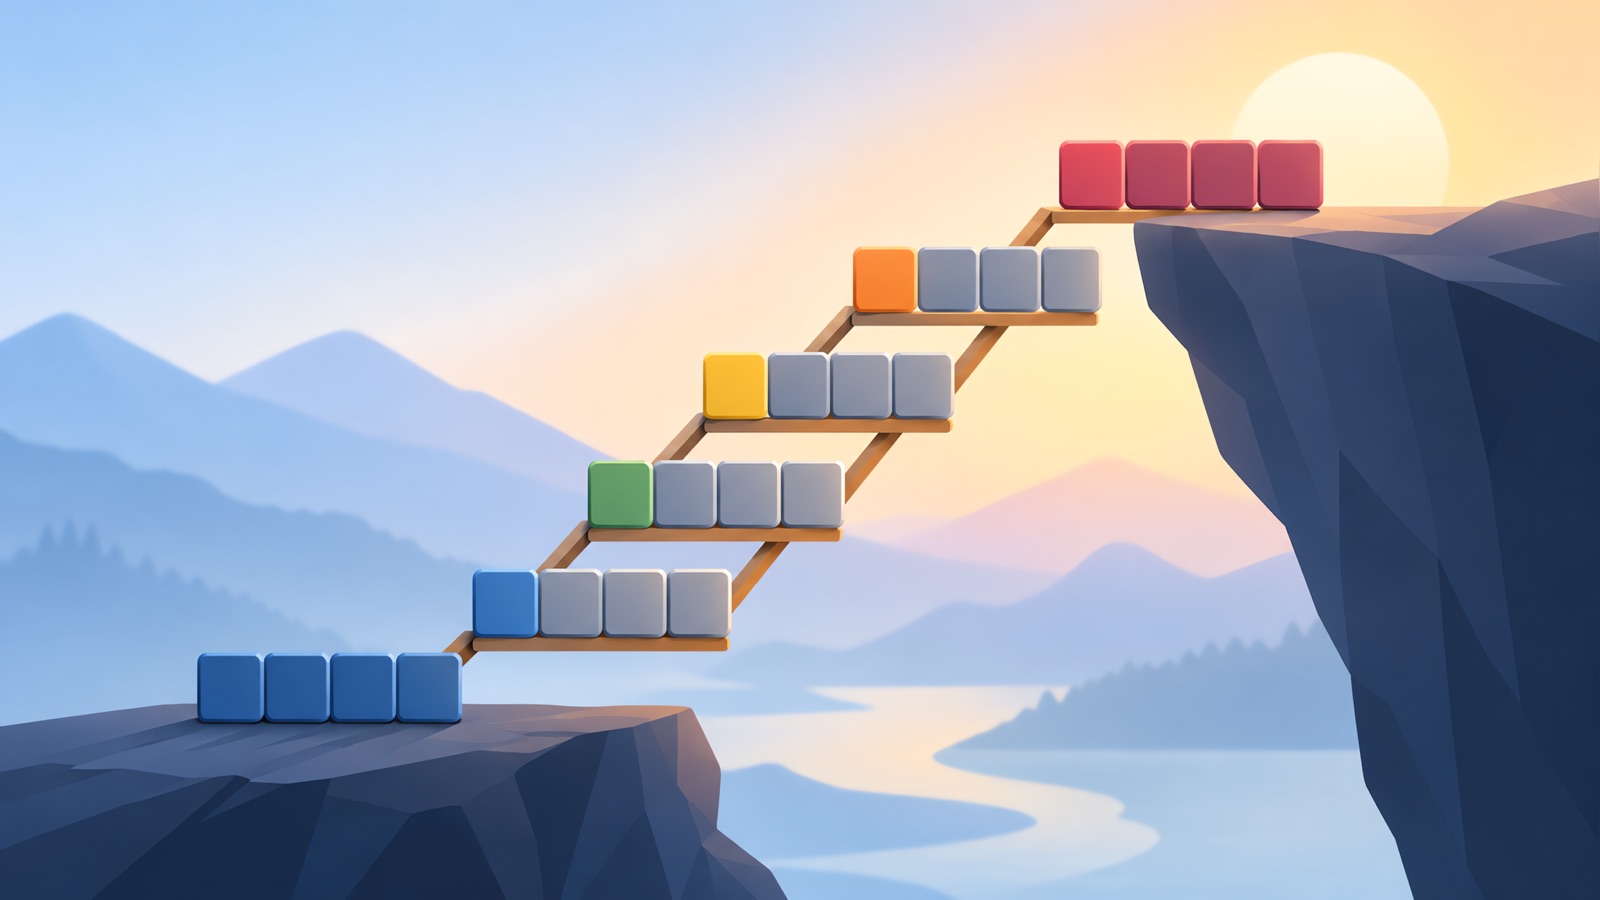
Word Ladder(LeetCode 127)は、ある単語から別の単語へ、1文字ずつ変えながら最短の連鎖の長さを求める問題です。各ステップの単語は与えられたリストに含まれている必要があります。すべての辺のコストが等しい最短経路なので、幅優先探索を使います。高速化のカギは、h*t のようなワイルドカードパターンで単語をグループ化し、総当たりで単語同士を比較しなくて済むようにすることです。
問題
beginWord、endWord、単語リストが与えられたとき、beginWord から endWord への最短変換シーケンスに含まれる単語の数を、両端も数えて返します。各ステップではちょうど1文字を変え、移動先の各単語はリストに含まれていなければなりません。そのようなシーケンスが存在しない場合は 0 を返します。
| 入力 | 出力 | 理由 |
|---|---|---|
| hit から cog、リスト hot dot dog lot log cog | 5 | hit, hot, dot, dog, cog |
| hit から cog、リスト hot dot dog lot log | 0 | cog がリストにない |
なぜ幅優先探索か
各単語をノードとみなし、1文字だけ異なる単語同士の間に辺を張ります。どの辺もコストは1ステップなので、最短のシーケンスは重みなしグラフの最短経路となり、幅優先探索が終点の単語に初めて到達したときにそれが見つかります。
総当たりでの辺の構築
すべての単語のペアを比較して1文字だけ異なるかを調べると、長さ L の単語が N 個ある場合に O(N の2乗 × L) かかります。数千語になると遅すぎます。そこで、パターンから隣接語を生成します。
アプローチ:ワイルドカードパターン
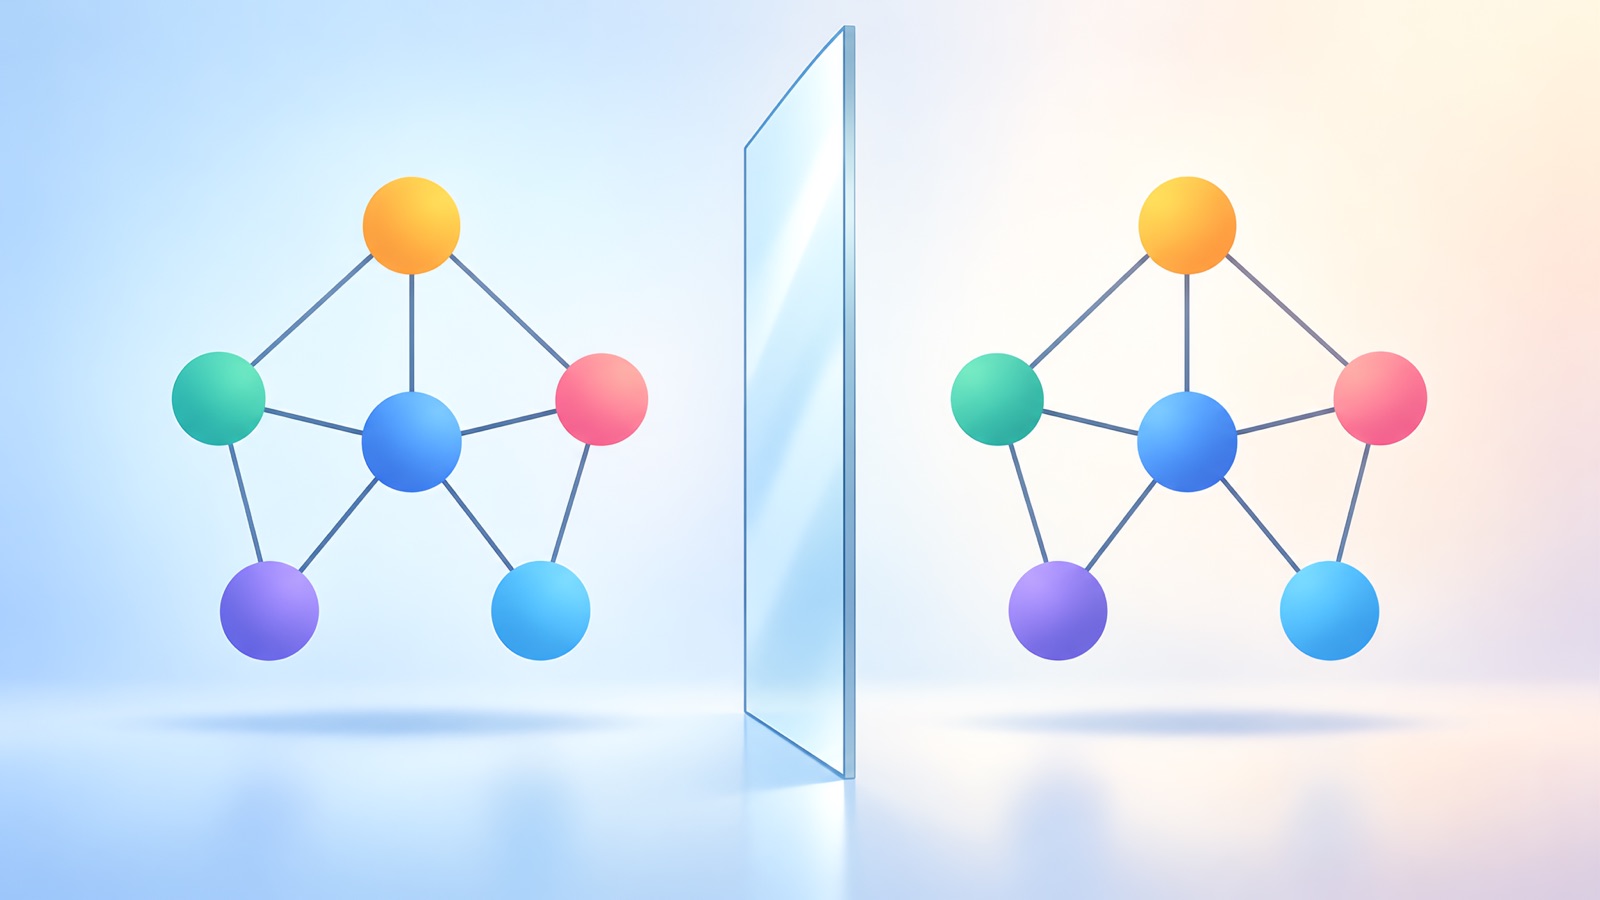
各文字を順番に * に置き換えます。hot は *ot、h*t、ho* になります。2つの単語は、同じパターンを共有するときにちょうど隣接します。パターンからそれに当てはまる単語へのマップを構築し、それを使って探索を実行します。
from collections import deque, defaultdict

def ladder_length(begin_word, end_word, word_list):
    words = set(word_list)
    if end_word not in words:
        return 0
    patterns = defaultdict(list)
    for w in words | {begin_word}:
        for i in range(len(w)):
            patterns[w[:i] + "*" + w[i + 1:]].append(w)
    queue = deque([(begin_word, 1)])
    seen = {begin_word}
    while queue:
        word, steps = queue.popleft()
        if word == end_word:
            return steps
        for i in range(len(word)):
            key = word[:i] + "*" + word[i + 1:]
            for nxt in patterns[key]:
                if nxt not in seen:
                    seen.add(nxt)
                    queue.append((nxt, steps + 1))
            patterns[key] = []
    return 0
重要なポイントが2つあります。開始単語はリストに含まれていなくてもパターンマップに追加します。そこから始めるからです。そして、あるパターンの単語を訪問した後は patterns[key] = [] で空にし、同じグループがそのパターンを共有する他の単語から何度も走査されないようにします。これにより、全体の処理量はパターン数に対して線形に保たれます。
計算量
パターンの構築には O(N × L) かかり、各パターン文字列の構築に O(L) かかるので、合計でおよそ O(N × L の2乗) になります。探索は各単語を1回、各パターングループを1回だけたどるので、同じ上限です。空間はパターンマップに O(N × L の2乗) で、各単語が長さ L の L 個のキーの下に保存されるためです。
さらなる高速化:双方向探索
開始単語からの探索と終了単語からの探索を同時に走らせ、常により小さいフロンティアを展開します。両者は途中で出会うので、それぞれの側は深さの半分だけ探索すれば済みます。面接官に高速化の方法を聞かれたら言及する価値がありますが、ほとんどの面接で書くことを期待されるよりコード量は多くなります。
よくある間違い
- 単語数ではなく変更回数を返してしまう。シーケンスには beginWord が含まれるので、例では 4 ではなく 5 になります。
- 探索の前に endWord がリストに含まれているかを確認していない。
- 総当たりの比較で隣接語を構築してタイムアウトする。
- 探索で単語を再訪問してしまい、ループしたり遅くなったりする。
- DFS を使うと、経路は見つかっても最短にはならない。
テストすべきエッジケース
| 入力 | 期待される結果 |
|---|---|
| endWord がリストにない | 0 |
| 1文字の単語 | リスト内の他のどの単語も1ステップ先 |
| 終了単語が開始単語から1ステップ | 2 |
| つながりのない単語 | 0 |
面接での説明の仕方
- グラフとして捉え直し、なぜ幅優先探索が最短経路を見つけるのかを述べる。
- 総当たりの比較は遅すぎると言い、ワイルドカードパターンを導入する。
- パターンマップ、キュー、訪問済みセットを書く。
- 編集回数ではなく単語数を数えると述べ、最初の例を示す。
- 計算量を伝え、双方向探索に言及する。
公開前に、上記のコードを2万件のランダムな小規模単語リストで、素朴な総当たりの幅優先探索と比較して検証しました。表にある2つの例も確認しています。このような簡単なランダムチェックは、練習するときに身につけておきたい習慣です。
関連する練習
計算量の用語についてはBig O チートシートを、次に何を練習すべきかについてはLeetCode Blind 75 リストを、練習の進め方についてはコーディング面接アシスタントガイドをご覧ください。
コードを書きながら、アプローチを声に出して説明しましょう。文字起こしを見れば、重要な観察をコードを書く前に述べたかどうかがわかります。ライブの評価では、AI ツールに関する雇用主のルールに従ってください。
YesToTheOffer でコーディング面接を練習しましょう
アプローチを声に出して説明し、後でトランスクリプトを確認しましょう。30分無料、サブスクリプション不要。