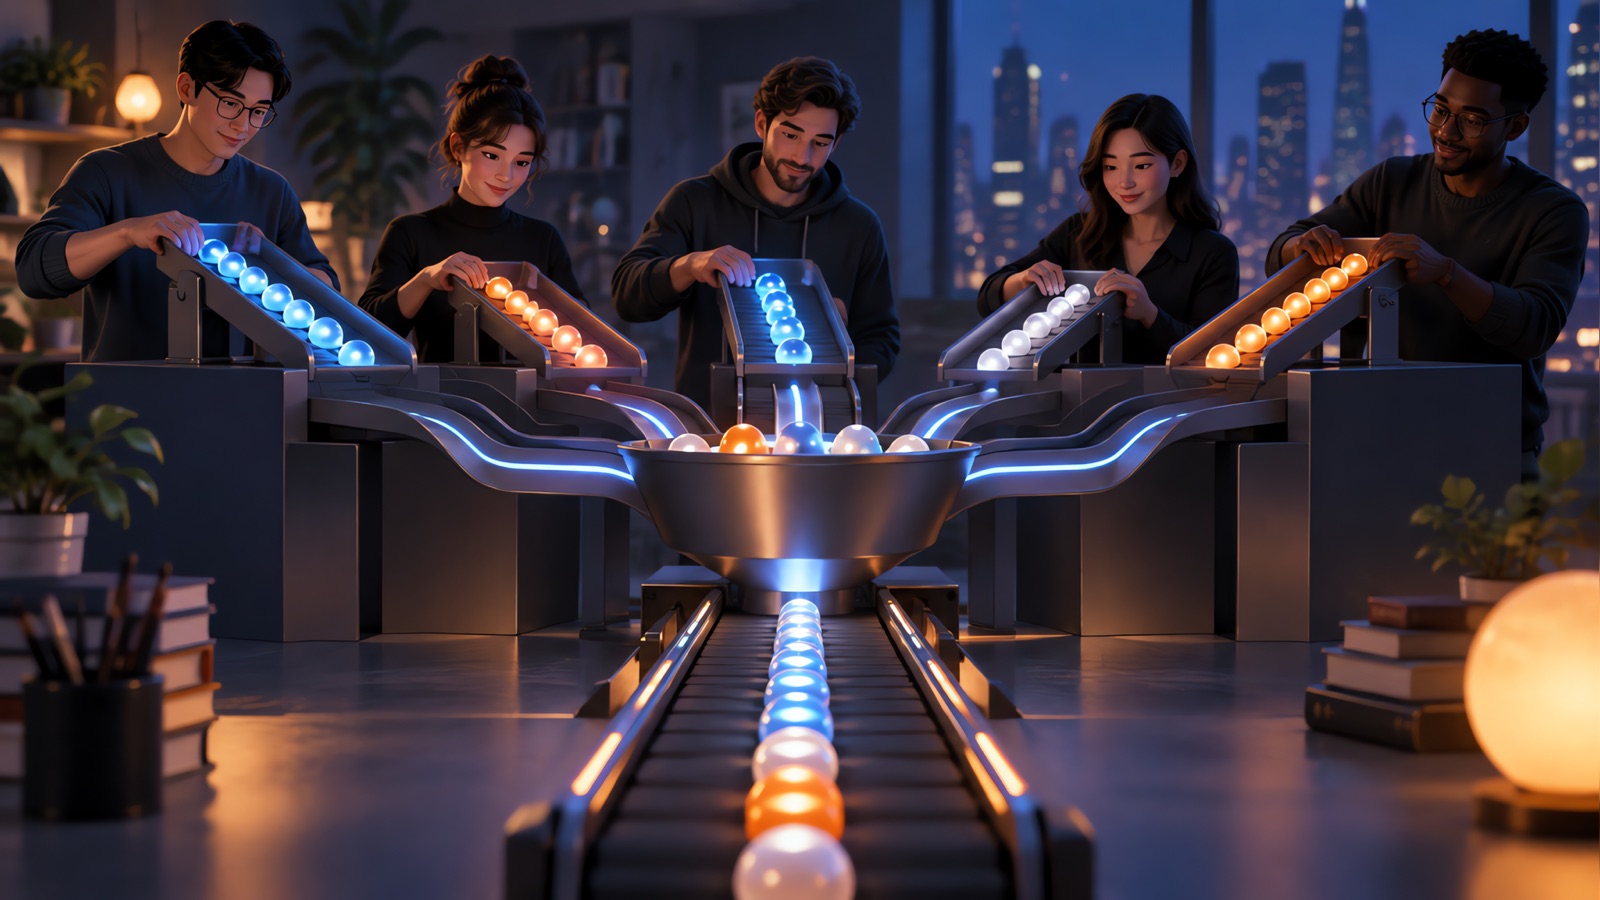
Merge k Sorted Lists (LeetCode 23) में आपको k sorted linked lists को एक sorted list में merge करना होता है। यह इसलिए popular है क्योंकि brute force साफ़ दिखता है, और असली मज़ा दो अच्छे तरीकों में से चुनने में है: min-heap या divide and conquer। दोनों O(N log k) में चलते हैं, जहाँ N कुल nodes की संख्या है।
समस्या
आपको k linked lists का एक array दिया गया है, हर एक ascending order में sorted है। इन्हें एक sorted linked list में merge करके return करना है।
उदाहरण: [[1,4,5],[1,3,4],[2,6]] बन जाता है [1,1,2,3,4,4,5,6]।
Interviewer से पूछने वाले सवाल:
- क्या array खाली हो सकता है, या उसमें खाली lists हो सकती हैं? (हाँ, दोनों handle करें।)
- क्या मुझे मौजूदा nodes दोबारा इस्तेमाल करने हैं या नए बनाने हैं? (दोबारा इस्तेमाल ठीक है और memory बचाता है।)
- क्या duplicate values हो सकती हैं? (हाँ, तो अगर मायने रखता है तो merge को stable रखें।)
Brute force
सारी values एक array में इकट्ठा करो, sort करो, और list दोबारा बना दो। Time O(N log N) है और space O(N)। यह काम करता है, लेकिन यह नज़रअंदाज़ करता है कि हर list पहले से sorted है, इसलिए इसे final answer के तौर पर शायद ही स्वीकार किया जाता है।
तरीका 1: min-heap
हर list के लिए एक pointer रखो। Output में अगला node हमेशा मौजूदा heads में सबसे छोटा होता है, इसलिए heads को एक min-heap में रखो।
- हर non-empty list के head को heap में push करो।
- सबसे छोटा pop करो, उसे result में append करो, और उसका next node हो तो push करो।
- तब तक दोहराओ जब तक heap खाली न हो जाए।
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
Index i tiebreaker है। इसके बिना, बराबर values वाली दो entries Python को ListNode objects की तुलना करने पर मजबूर कर देंगी, जिससे TypeError आएगा।
Complexity: N में से हर node एक बार heap में जाता है और एक बार बाहर आता है, और हर operation O(log k) का है, इसलिए time O(N log k) है। Heap में ज़्यादा से ज़्यादा k nodes होते हैं, इसलिए extra space O(k) है।
तरीका 2: divide and conquer
दो sorted lists को merge करना आसान है और इसमें O(n) time लगता है। Lists को जोड़ों में merge करो, फिर results को जोड़ों में merge करो, और इसी तरह, एक tournament की तरह।
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
Complexity: लगभग log k rounds होते हैं, और हर round सभी N nodes को एक बार छूता है, इसलिए time O(N log k) है। Loop वाले version को heads की list के अलावा सिर्फ़ O(1) extra space चाहिए।
एक-एक करके merge क्यों नहीं?
List 1 को list 2 के साथ merge करना, फिर result को list 3 के साथ, और इसी तरह, natural लगता है लेकिन ज़्यादा महँगा पड़ता है। पहली list k merges से होकर गुज़रती है। अगर हर list में n nodes हैं, तो कुल काम लगभग n x (1 + 2 + ... + k) है, जो O(n k squared) है। Lists को जोड़ों में मिलाने से sizes balanced रहते हैं, इसलिए हर node लगभग log k बार छुआ जाता है।
दोनों की तुलना
| Min-heap | Divide and conquer | |
|---|---|---|
| Time | O(N log k) | O(N log k) |
| Extra space | O(k) | Loop वाले version के साथ O(1) |
| Code | छोटा, tiebreaker चाहिए | merge_two दोबारा इस्तेमाल करता है |
| कब अच्छा | जब lists streams की तरह आती हैं या आपको सिर्फ़ पहले कुछ results चाहिए | जब सारी lists memory में हों |
अगर interviewer कहे कि lists memory के लिए बहुत बड़ी हैं और streams की तरह आती हैं, तो heap वाला तरीका स्वाभाविक रूप से आगे बढ़ जाता है, क्योंकि उसे हर stream का सिर्फ़ मौजूदा head चाहिए।
Test करने वाले edge cases
| Input | Expected |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| एक non-empty list | वही list |
| Lists में duplicate values | सब बरकरार, order में |
| Negative numbers | वैसे ही handle होते हैं |
| बहुत असमान लंबाई | Handle होता है, क्योंकि बची हुई list अंत में जोड़ दी जाती है |
Interview में इसे कैसे समझाएँ
- Brute force बताओ और क्यों यह फ़िज़ूल है।
- मुख्य observation कहो: अगला output node सबसे छोटा मौजूदा head है।
- Heap चुनो, लिखो, और tiebreaker का ज़िक्र करो।
- Complexity बताओ: O(N log k) time और O(k) space।
- O(1) space वाले विकल्प के तौर पर divide and conquer offer करो।
- खाली input और duplicates वाले input से test करो।
Publish करने से पहले मैंने ऊपर के दोनों versions को 3,000 random inputs पर sorting-based check के खिलाफ़ test किया, जिनमें खाली lists भी थीं। ऐसा तेज़ random check करना practice करते समय एक अच्छी आदत है।
संबंधित अभ्यास
अगर यह आसान लगा, तो पहले Merge Two Sorted Lists आज़माओ, फिर Sort List और Find Median from Data Stream, जो यही ideas इस्तेमाल करते हैं। Complexity की शब्दावली के लिए हमारी Big O cheat sheet देखो, dynamic programming के लिए longest common substring guide, और practice करने के तरीके के लिए coding interview assistant guide।
Code करते समय अपना approach ज़ोर से बोलकर समझाओ। एक mock interview transcript दिखाता है कि आपने लिखने से पहले मुख्य observation समझाया या नहीं। किसी भी live assessment में AI tools को लेकर employer के नियमों का पालन करो।
YesToTheOffer के साथ कोडिंग इंटरव्यू का अभ्यास करें
एक मॉक कोडिंग इंटरव्यू चलाएं, अपने दृष्टिकोण को जोर से समझाएं, और बाद में अपने ट्रांसक्रिप्ट की समीक्षा करें। 30 मुफ्त मिनट, कोई सदस्यता नहीं।