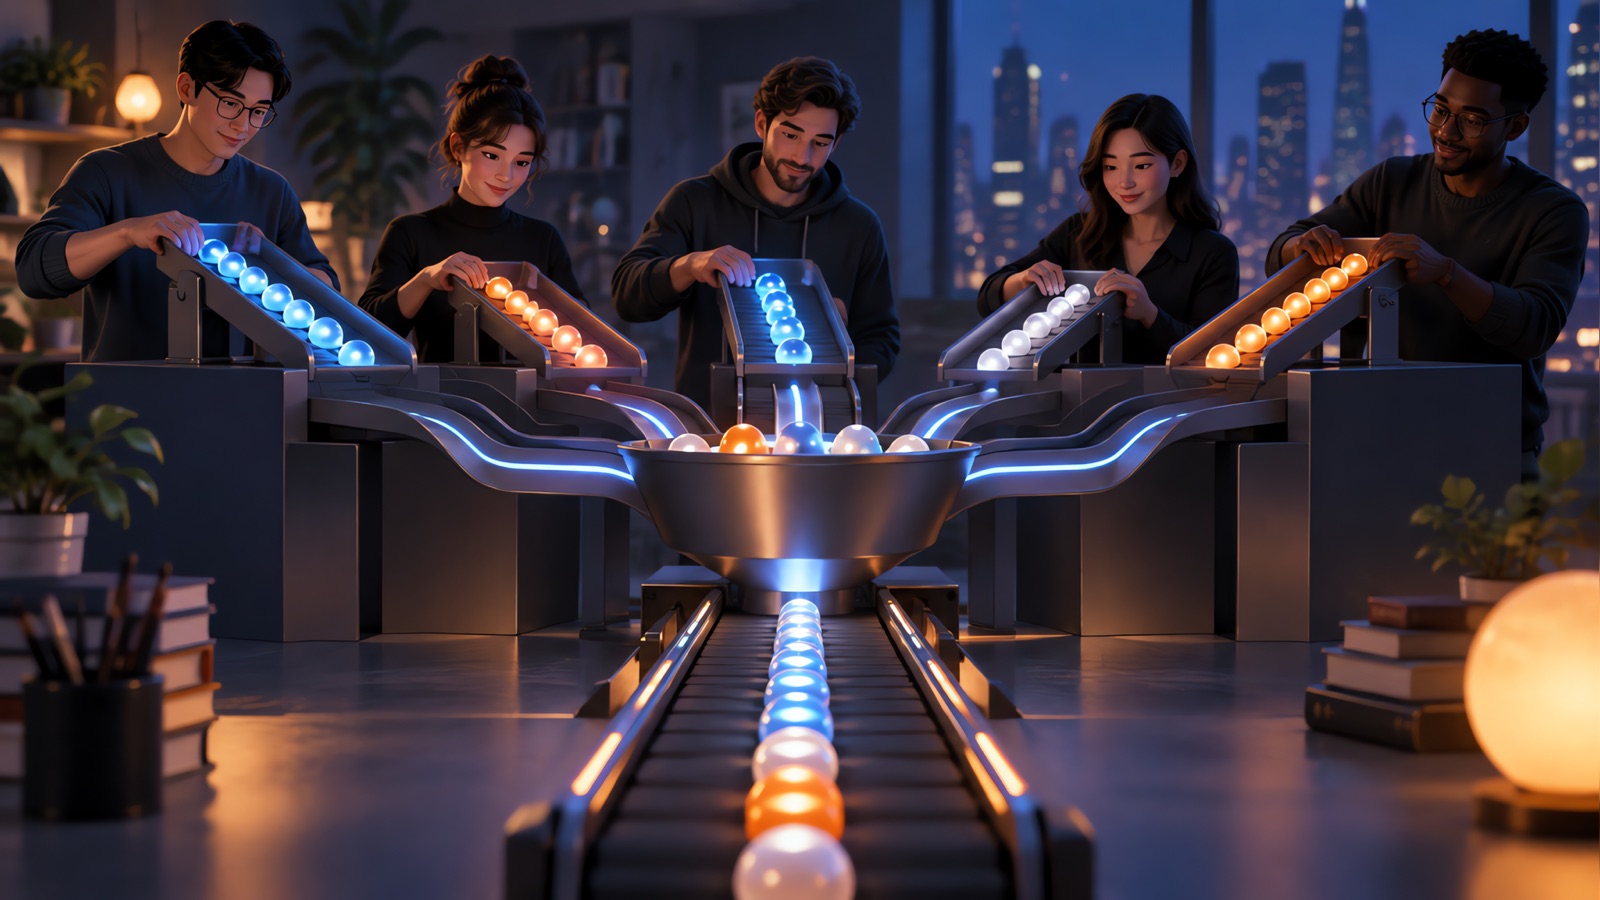
Het samenvoegen van k gesorteerde linked lists (LeetCode 23) vraagt je om k gesorteerde linked lists samen te voegen tot één gesorteerde lijst. Het is populair omdat de brute force voor de hand ligt, en het interessante deel zit in het kiezen tussen twee goede manieren om het beter te doen: een min-heap of divide and conquer. Beide draaien in O(N log k), waarbij N het totale aantal nodes is.
Het probleem
Gegeven een array van k linked lists, elk oplopend gesorteerd, voeg ze samen tot één gesorteerde linked list en retourneer die.
Voorbeeld: [[1,4,5],[1,3,4],[2,6]] wordt [1,1,2,3,4,4,5,6].
Vragen om aan de interviewer te stellen:
- Kan de array leeg zijn, of lege lists bevatten? (Ja, behandel beide.)
- Moet ik de bestaande nodes hergebruiken of nieuwe maken? (Hergebruiken is prima en bespaart geheugen.)
- Zijn dubbele waarden mogelijk? (Ja, dus houd de merge stabiel als dat uitmaakt.)
Brute force
Verzamel alle waarden in een array, sorteer die, en bouw een lijst opnieuw op. De tijd is O(N log N) en de ruimte is O(N). Het werkt, maar het negeert dat elke lijst al gesorteerd is, dus het wordt zelden geaccepteerd als het uiteindelijke antwoord.
Aanpak 1: een min-heap
Houd één pointer per lijst bij. De volgende node in de output is altijd de kleinste onder de huidige heads, dus houd de heads in een min-heap.
- Push de head van elke niet-lege lijst op de heap.
- Pop de kleinste, voeg die toe aan het resultaat, en push de volgende node als die er is.
- Herhaal tot de heap leeg is.
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
De index i is een tiebreaker. Zonder die zouden twee entries met gelijke waarden Python ListNode-objecten laten vergelijken, wat een TypeError oplevert.
Complexiteit: elk van de N nodes gaat één keer de heap in en komt er één keer uit, en elke operatie kost O(log k), dus de tijd is O(N log k). De heap bevat hoogstens k nodes, dus extra ruimte is O(k).
Aanpak 2: divide and conquer
Twee gesorteerde lijsten samenvoegen is makkelijk en kost O(n) tijd. Voeg de lijsten paarsgewijs samen, voeg daarna de resultaten paarsgewijs samen, enzovoort, als een toernooi.
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
Complexiteit: er zijn ongeveer log k rondes, en elke ronde raakt alle N nodes één keer aan, dus de tijd is O(N log k). De loop-versie heeft slechts O(1) extra ruimte nodig, afgezien van de lijst met heads.
Waarom niet één voor één samenvoegen?
Lijst 1 samenvoegen met lijst 2, dan het resultaat met lijst 3, enzovoort, lijkt logisch maar kost meer. De eerste lijst wordt door k merges heen gekopieerd. Als elke lijst n nodes heeft, is het totale werk ongeveer n x (1 + 2 + ... + k), wat O(n k kwadraat) is. Lijsten paarsgewijs koppelen houdt de groottes in balans, zodat elke node ongeveer log k keer wordt aangeraakt.
De twee vergelijken
| Min-heap | Divide and conquer | |
|---|---|---|
| Tijd | O(N log k) | O(N log k) |
| Extra ruimte | O(k) | O(1) met de loop-versie |
| Code | Kort, heeft een tiebreaker nodig | Hergebruikt merge_two |
| Goed wanneer | Lijsten als streams binnenkomen of je alleen de eerste paar resultaten nodig hebt | Je alle lijsten in het geheugen hebt |
Als een interviewer zegt dat de lijsten te groot zijn voor het geheugen en als streams binnenkomen, dan sluit de heap-aanpak daar natuurlijk op aan, omdat die alleen de huidige head van elke stream nodig heeft.
Edge cases om te testen
| Input | Verwacht |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| Eén niet-lege lijst | Die lijst |
| Dubbele waarden verspreid over lijsten | Allemaal behouden, in volgorde |
| Negatieve getallen | Op dezelfde manier behandeld |
| Zeer ongelijke lengtes | Behandeld, omdat de resterende lijst aan het einde wordt vastgekoppeld |
Hoe je het uitlegt in een interview
- Noem de brute force en waarom die verspillend is.
- Noem de belangrijkste observatie: de volgende output-node is de kleinste huidige head.
- Kies de heap, schrijf die, en noem de tiebreaker.
- Noem de complexiteit: O(N log k) tijd en O(k) ruimte.
- Bied divide and conquer aan als het O(1)-ruimte-alternatief.
- Test met een lege input en een met duplicaten.
Ik heb beide versies hierboven getest tegen een op sorteren gebaseerde controle op 3.000 willekeurige inputs, inclusief lege lijsten, voordat ik publiceerde. Zo'n snelle willekeurige controle doen is een goede gewoonte wanneer je oefent.
Gerelateerde oefening
Als dit makkelijk was, probeer eerst Merge Two Sorted Lists, en daarna Sort List en Find Median from Data Stream, die dezelfde ideeën gebruiken. Zie onze Big O cheat sheet voor de complexiteitstermen, de longest common substring guide voor dynamic programming, en de coding interview assistant guide voor hoe je oefent.
Praat je aanpak hardop door terwijl je codeert. Een mock-interviewtranscript laat zien of je de belangrijkste observatie hebt uitgelegd voordat je begon te schrijven. Volg de regels van de werkgever over AI-tools in elke live assessment.
Oefen sollicitatiegesprekken voor programmeurs met YesToTheOffer
Doe een mock-sollicitatiegesprek voor programmeurs, leg je aanpak hardop uit en bekijk achteraf je transcript. 30 gratis minuten, geen abonnement.