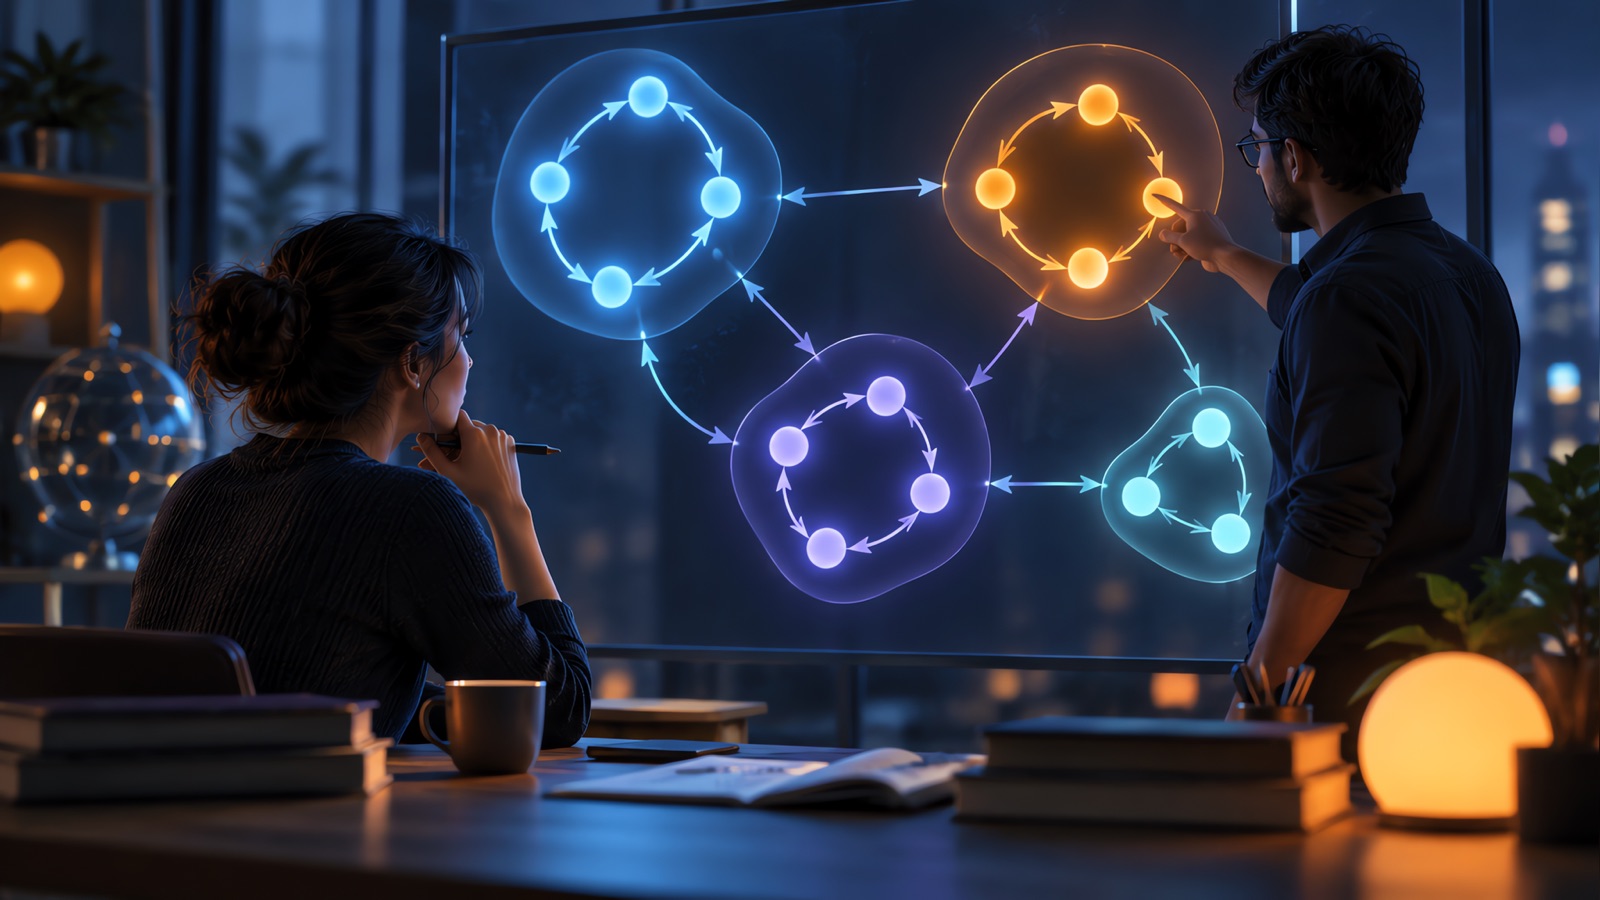
Kosarajuのアルゴリズムは、有向グラフの強連結成分(SCC)を見つけるアルゴリズムです。SCCとは、どの頂点からも他のすべての頂点に到達できる頂点のグループのことです。このアルゴリズムは2回の深さ優先探索を行います。1回目は頂点が探索を終える順序を記録し、2回目はすべての辺を逆向きにしたグラフ上で、探索終了順の逆順に頂点を処理します。2回目の探索で得られる各木が1つのSCCです。計算量はO(V + E)です。
各SCCを1つのノードに潰すと、残るのは閉路のない有向グラフです。だからこそSCCは、依存関係の分析、デッドロック検出、2-SAT、そして閉路を先に潰す必要があるあらゆる問題で登場します。
2つのパスの手順
- グラフ全体に対してDFSを実行します。頂点の探索が終わったとき(出ていく隣接頂点がすべて処理済みになったとき)、その頂点をリストに追加します。
- すべての辺を反転させて転置グラフを作ります。
- 探索終了リストを後ろから前へたどります。まだ訪問していない頂点ごとに、転置グラフ上でDFSを実行します。その探索が到達するすべての頂点が1つのSCCです。
グラフは連結とは限らないため、どちらのループも頂点0だけでなく、未訪問のすべての頂点から開始する必要があります。
具体例で確認する
8つの頂点と、次の辺を考えます。
0 → 1, 1 → 2, 2 → 0      (cycle A: 0, 1, 2)
2 → 3
3 → 4, 4 → 5, 5 → 3      (cycle B: 3, 4, 5)
6 → 5
6 → 7, 7 → 6             (cycle C: 6, 7)
SCCは2、5、7になるはずです。
1回目のパス
頂点0からDFSを開始し、0 → 1 → 2 → 3 → 4 → 5と進みます。頂点5は新しく行ける先がないので最初に探索が終わり、次に4、そして3が終わります。2に戻ると残りはないので、2、1、0の順に終わります。頂点6はまだ訪問していないので、そこから開始します。5はすでに処理済みなので7へ進み、7が終わってから6が終わります。探索終了順は次のとおりです。
5, 4, 3, 2, 1, 0, 7, 6
2回目のパス
すべての辺を反転させ、リストの末尾から頂点を処理します。まず6です。反転グラフでは6は7にしか到達できないので、7が最初のSCCです。次に未訪問の0は、反転グラフで2と1に到達でき、2が得られます。辺2 → 3は反転して3 → 2になりますが、2はすでに割り当て済みなので、探索はそこで止まります。最後に3は5と4に到達し、5が得られます。
なぜ正しく動くのか
SCCをグラフにしたもの(各成分を1つのノードに潰したもの)を考えると、これには閉路がありません。1回目のパスで最後に探索が終わる頂点は、常に「ソース」成分、つまり他の未割り当て成分から入ってくる辺がない成分に属します。辺を反転させるとそのソースはシンクに変わるので、そこから開始したDFSは自分の成分の外に出られません。その成分を取り除けば、同じ論法が次の成分にも当てはまります。
面接では、通常この程度の証明が期待されます。つまり、探索終了順が安全な開始成分を選び、辺を反転させることで2回目の探索が他の成分へ漏れ出すのを防ぐ、という説明です。
Python実装
このバージョンは反復的なDFSを使うので、深いグラフでもPythonの再帰上限に引っかかりません。
from collections import defaultdict

def kosaraju(n, edges):
    graph = defaultdict(list)
    reverse = defaultdict(list)
    for u, v in edges:
        graph[u].append(v)
        reverse[v].append(u)

    # Pass 1: record vertices in the order they finish (iterative DFS)
    visited = [False] * n
    order = []
    for start in range(n):
        if visited[start]:
            continue
        visited[start] = True
        stack = [(start, iter(graph[start]))]
        while stack:
            node, neighbors = stack[-1]
            for nxt in neighbors:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append((nxt, iter(graph[nxt])))
                    break
            else:
                stack.pop()
                order.append(node)

    # Pass 2: DFS on the reversed graph, latest finish time first
    visited = [False] * n
    components = []
    for start in reversed(order):
        if visited[start]:
            continue
        visited[start] = True
        component = []
        stack = [start]
        while stack:
            node = stack.pop()
            component.append(node)
            for nxt in reverse[node]:
                if not visited[nxt]:
                    visited[nxt] = True
                    stack.append(nxt)
        components.append(component)
    return components


edges = [(0, 1), (1, 2), (2, 0), (2, 3), (3, 4), (4, 5), (5, 3), (6, 5), (6, 7), (7, 6)]
print(kosaraju(8, edges))  # [[6, 7], [0, 2, 1], [3, 5, 4]]
各成分内の頂点の順序は探索の仕方に依存するため、テストでは成分を集合として比較してください。この実装は2,000個のランダムグラフで、総当たりの到達可能性チェックと照合して確認済みです。
計算量
| ステップ | 時間 |
|---|---|
| 1回目のDFS | O(V + E) |
| 反転グラフの構築 | O(V + E) |
| 2回目のDFS | O(V + E) |
| 合計 | O(V + E) |
空間は2つの隣接リストでO(V + E)、さらに訪問済み配列、探索終了順、スタックでO(V)です。
壊してしまう間違い
最もよくあるバグは、DFSが頂点に最初に到達した時点で記録してしまい、探索が終わった時点で記録しないことです。他には、2回目のパスで探索終了順を逆にするのを忘れる、2回目のパスを反転グラフではなく元のグラフで実行する、パス間で訪問済み配列をクリアしない、頂点0からしか開始せず非連結部分が飛ばされる、といったものがあります。再帰的DFSは長い鎖でスタックオーバーフローを起こすこともあり、だからこそ上記のコードは反復的になっています。
良いテストケースとしては、頂点1つ、自己ループを持つ頂点、1つの大きな閉路、一方向の鎖(すべての頂点がそれぞれ独立したSCC)、1本の辺でつながれた2つの閉路、非連結グラフなどがあります。
Kosaraju vs. Tarjan
どちらもO(V + E)で動作します。Kosarajuは2回のパスを行い、反転グラフを構築するため、説明しやすく正しく実装しやすいです。Tarjanのアルゴリズムは反転グラフなしの1回のパスで済みますが、スタック上で発見インデックスとlow-link値を追跡する必要があり、管理すべき状態が多くなります。面接では、正しく実装して説明できるほうを使いましょう。面接官が1回のパスを求めてきたら、それはTarjanの合図です。
グラフ問題の練習
コードを書く前に、上の例を一度手でたどってみてください。ほとんどのバグは探索終了順の誤りとして現れます。関連ガイド:Floyd–Warshallは全点対最短経路、Bellman–Fordは負の辺を持つグラフ、そしてBig O チートシートもご覧ください。コーディング練習でYesToTheOfferを使うなら、そのスクリーンショットによるコーディング支援でアプローチを確認でき、セッションの記録から自分の推論を明確に説明できたかがわかります。
フィードバック付きでコーディング面接を練習
コーディング支援のスクリーンショットと練習セッションの記録。30分無料。