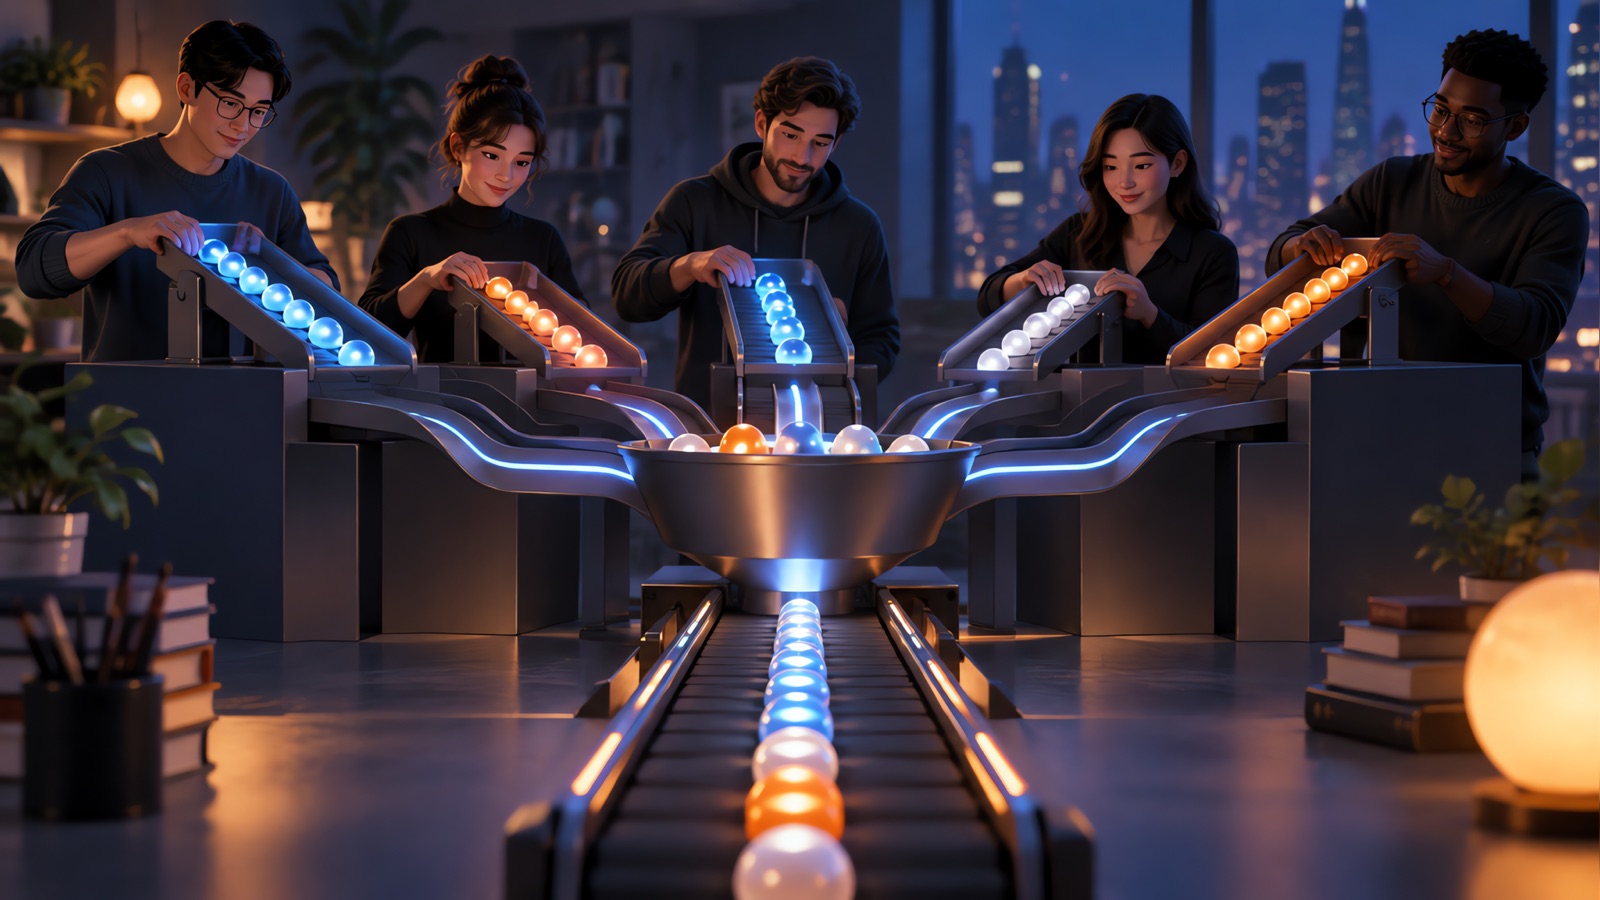
Unire k liste ordinate (LeetCode 23) ti chiede di fondere k liste collegate ordinate in un'unica lista ordinata. È un problema popolare perché la soluzione brute force è ovvia, e la parte interessante è scegliere tra due buoni modi per fare meglio: un min-heap o divide et impera. Entrambi girano in O(N log k), dove N è il numero totale di nodi.
Il problema
Data una array di k liste collegate, ciascuna ordinata in modo crescente, fondile in un'unica lista collegata ordinata e restituiscila.
Esempio: [[1,4,5],[1,3,4],[2,6]] diventa [1,1,2,3,4,4,5,6].
Domande da fare all'intervistatore:
- L'array può essere vuoto, o contenere liste vuote? (Sì, gestisci entrambi i casi.)
- Devo riutilizzare i nodi esistenti o crearne di nuovi? (Riutilizzare va bene e risparmia memoria.)
- Sono possibili valori duplicati? (Sì, quindi mantieni la fusione stabile se è importante.)
Brute force
Raccogli tutti i valori in un array, ordinalo e ricostruisci una lista. Il tempo è O(N log N) e lo spazio è O(N). Funziona, ma ignora che ogni lista è già ordinata, quindi raramente viene accettata come risposta finale.
Approccio 1: un min-heap
Mantieni un puntatore per lista. Il prossimo nodo nell'output è sempre il più piccolo tra le teste correnti, quindi tieni le teste in un min-heap.
- Inserisci la testa di ogni lista non vuota nello heap.
- Estrai la più piccola, aggiungila al risultato e inserisci il suo nodo successivo se esiste.
- Ripeti finché lo heap è vuoto.
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
L'indice i è un tiebreaker. Senza di esso, due elementi con valori uguali farebbero confrontare a Python oggetti ListNode, il che solleva un TypeError.
Complessità: ciascuno degli N nodi entra nello heap una volta ed esce una volta, e ogni operazione costa O(log k), quindi il tempo è O(N log k). Lo heap contiene al massimo k nodi, quindi lo spazio extra è O(k).
Approccio 2: divide et impera
Fondere due liste ordinate è facile e richiede tempo O(n). Fondi le liste a coppie, poi fondi i risultati a coppie, e così via, come in un torneo.
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
Complessità: ci sono circa log k round, e ogni round tocca tutti gli N nodi una volta, quindi il tempo è O(N log k). La versione con il loop richiede solo O(1) spazio extra a parte la lista delle teste.
Perché non fondere una alla volta?
Fondere la lista 1 con la lista 2, poi il risultato con la lista 3, e così via, sembra naturale ma costa di più. La prima lista viene copiata attraverso k fusioni. Se ogni lista ha n nodi, il lavoro totale è circa n x (1 + 2 + ... + k), che è O(n k al quadrato). Accoppiare le liste mantiene le dimensioni bilanciate, quindi ogni nodo viene toccato circa log k volte.
Confronto tra i due
| Min-heap | Divide et impera | |
|---|---|---|
| Tempo | O(N log k) | O(N log k) |
| Spazio extra | O(k) | O(1) con la versione con il loop |
| Codice | Breve, richiede un tiebreaker | Riutilizza merge_two |
| Buono quando | Le liste arrivano come stream o ti servono solo i primi risultati | Hai tutte le liste in memoria |
Se un intervistatore dice che le liste sono troppo grandi per la memoria e arrivano come stream, l'approccio con lo heap si estende naturalmente, dato che richiede solo la testa corrente di ogni stream.
Casi limite da testare
| Input | Atteso |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| Una lista non vuota | Quella lista |
| Valori duplicati tra le liste | Tutti mantenuti, in ordine |
| Numeri negativi | Gestiti allo stesso modo |
| Lunghezze molto diverse | Gestite, dato che la lista rimanente viene attaccata alla fine |
Come spiegarlo in un colloquio
- Esponi la brute force e perché è inefficiente.
- Di' l'osservazione chiave: il prossimo nodo in output è la testa corrente più piccola.
- Scegli lo heap, scrivilo e menziona il tiebreaker.
- Dichiara la complessità: O(N log k) tempo e O(k) spazio.
- Offri divide et impera come alternativa con O(1) spazio.
- Testa con un input vuoto e uno con duplicati.
Ho testato entrambe le versioni qui sopra contro un controllo basato sull'ordinamento su 3.000 input casuali, incluse liste vuote, prima di pubblicare. Fare un rapido controllo casuale come questo è una buona abitudine quando ti eserciti.
Esercizi correlati
Se questo è stato facile, prova prima Merge Two Sorted Lists, poi Sort List e Find Median from Data Stream, che usano le stesse idee. Consulta il nostro Big O cheat sheet per i termini di complessità, la guida alla longest common substring per la programmazione dinamica, e la guida all'assistente per colloqui di programmazione per come esercitarti.
Parla ad alta voce del tuo approccio mentre scrivi il codice. Una trascrizione di un colloquio simulato mostra se hai spiegato l'osservazione chiave prima di scrivere. Segui le regole del datore di lavoro sugli strumenti di AI in qualsiasi valutazione dal vivo.
Esercitati per i colloqui di programmazione con YesToTheOffer
Fai un colloquio tecnico simulato, spiega il tuo approccio ad alta voce e rileggi la trascrizione in seguito. 30 minuti gratuiti, nessun abbonamento.