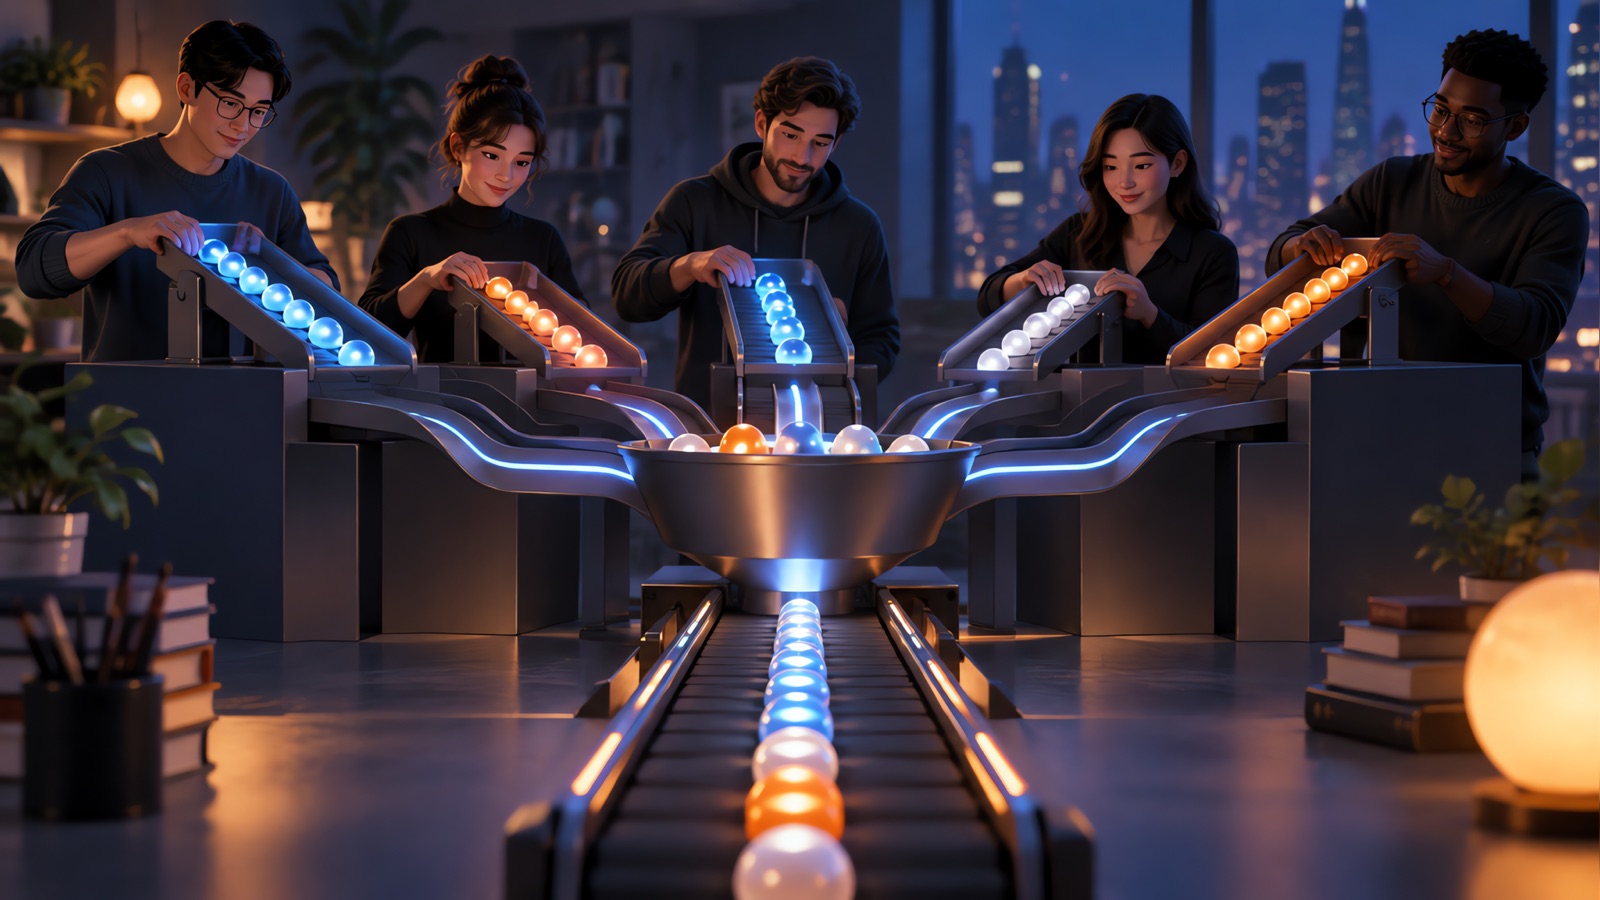
Fusionner k listes triées (LeetCode 23) vous demande de fusionner k listes chaînées triées en une seule liste triée. Ce problème est populaire parce que la force brute est évidente, et la partie intéressante consiste à choisir entre deux bonnes façons de faire mieux : un tas min ou diviser pour régner. Les deux s'exécutent en O(N log k), où N est le nombre total de nœuds.
Le problème
Étant donné un tableau de k listes chaînées, chacune triée par ordre croissant, fusionnez-les en une seule liste chaînée triée et renvoyez-la.
Exemple : [[1,4,5],[1,3,4],[2,6]] devient [1,1,2,3,4,4,5,6].
Questions à poser à l'interviewer :
- Le tableau peut-il être vide, ou contenir des listes vides ? (Oui, gérez les deux cas.)
- Dois-je réutiliser les nœuds existants ou en créer de nouveaux ? (La réutilisation convient et économise de la mémoire.)
- Des valeurs en double sont-elles possibles ? (Oui, donc gardez la fusion stable si cela compte.)
Force brute
Rassemblez toutes les valeurs dans un tableau, triez-le, et reconstruisez une liste. Le temps est O(N log N) et l'espace est O(N). Ça fonctionne, mais cela ignore que chaque liste est déjà triée, donc c'est rarement accepté comme réponse finale.
Approche 1 : un tas min
Gardez un pointeur par liste. Le prochain nœud de la sortie est toujours le plus petit parmi les têtes actuelles, donc gardez les têtes dans un tas min.
- Empilez la tête de chaque liste non vide dans le tas.
- Dépilez la plus petite, ajoutez-la au résultat, et empilez son nœud suivant s'il existe.
- Répétez jusqu'à ce que le tas soit vide.
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
L'indice i sert de départage. Sans lui, deux entrées avec des valeurs égales feraient comparer à Python des objets ListNode, ce qui lèverait une TypeError.
Complexité : chacun des N nœuds entre dans le tas une fois et en sort une fois, et chaque opération coûte O(log k), donc le temps est O(N log k). Le tas contient au plus k nœuds, donc l'espace supplémentaire est O(k).
Approche 2 : diviser pour régner
Fusionner deux listes triées est facile et prend un temps O(n). Fusionnez les listes par paires, puis fusionnez les résultats par paires, et ainsi de suite, comme un tournoi.
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
Complexité : il y a environ log k tours, et chaque tour touche tous les N nœuds une fois, donc le temps est O(N log k). La version avec boucle ne nécessite que O(1) d'espace supplémentaire en dehors de la liste des têtes.
Pourquoi ne pas fusionner une par une ?
Fusionner la liste 1 avec la liste 2, puis le résultat avec la liste 3, et ainsi de suite, semble naturel mais coûte plus cher. La première liste est copiée à travers k fusions. Si chaque liste a n nœuds, le travail total est d'environ n x (1 + 2 + ... + k), ce qui est O(n k au carré). Apparier les listes garde les tailles équilibrées, donc chaque nœud est touché environ log k fois.
Comparaison des deux
| Tas min | Diviser pour régner | |
|---|---|---|
| Temps | O(N log k) | O(N log k) |
| Espace supplémentaire | O(k) | O(1) avec la version avec boucle |
| Code | Court, nécessite un départage | Réutilise merge_two |
| Bon quand | Les listes arrivent en flux ou vous n'avez besoin que des premiers résultats | Vous avez toutes les listes en mémoire |
Si un interviewer dit que les listes sont trop volumineuses pour la mémoire et arrivent en flux, l'approche par tas s'étend naturellement, puisqu'elle n'a besoin que de la tête actuelle de chaque flux.
Cas limites à tester
| Entrée | Attendu |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| Une liste non vide | Cette liste |
| Valeurs en double entre les listes | Toutes conservées, dans l'ordre |
| Nombres négatifs | Traités de la même façon |
| Longueurs très inégales | Traité, puisque la liste restante est attachée à la fin |
Comment l'expliquer en entretien
- Énoncez la force brute et pourquoi elle est gaspilleuse.
- Dites l'observation clé : le prochain nœud de sortie est la plus petite tête actuelle.
- Choisissez le tas, écrivez-le, et mentionnez le départage.
- Énoncez la complexité : O(N log k) en temps et O(k) en espace.
- Proposez diviser pour régner comme alternative en O(1) d'espace.
- Testez avec une entrée vide et une avec des doublons.
J'ai testé les deux versions ci-dessus contre une vérification basée sur le tri sur 3 000 entrées aléatoires, y compris des listes vides, avant de publier. Faire une vérification aléatoire rapide comme celle-ci est une bonne habitude lorsque vous vous entraînez.
Entraînement associé
Si c'était facile, essayez d'abord Fusionner deux listes triées, puis Trier une liste et Trouver la médiane d'un flux de données, qui utilisent les mêmes idées. Consultez notre aide-mémoire Big O pour les termes de complexité, le guide sur la plus longue sous-chaîne commune pour la programmation dynamique, et le guide sur l'assistant d'entretien de codage pour savoir comment vous entraîner.
Exprimez votre approche à voix haute pendant que vous codez. Une transcription d'entretien simulé montre si vous avez expliqué l'observation clé avant d'écrire. Suivez les règles de l'employeur sur les outils d'IA dans toute évaluation en direct.
Entraînez-vous aux entretiens de codage avec YesToTheOffer
Faites un entretien de codage simulé, expliquez votre approche à voix haute et révisez votre transcription par la suite. 30 minutes gratuites, sans abonnement.