Fusionar k listas ordenadas (LeetCode 23) te pide fusionar k listas enlazadas ordenadas en una sola lista ordenada. Es popular porque la fuerza bruta es obvia, y la parte interesante es elegir entre dos buenas formas de mejorarla: un min-heap o divide y vencerás. Ambas se ejecutan en O(N log k), donde N es el número total de nodos.
El problema
Dado un arreglo de k listas enlazadas, cada una ordenada de forma ascendente, fusiónalas en una sola lista enlazada ordenada y devuélvela.
Ejemplo: [[1,4,5],[1,3,4],[2,6]] se convierte en [1,1,2,3,4,4,5,6].
Preguntas para hacerle al entrevistador:
- ¿El arreglo puede estar vacío o contener listas vacías? (Sí, maneja ambos casos).
- ¿Debo reutilizar los nodos existentes o crear nuevos? (Reutilizar está bien y ahorra memoria).
- ¿Son posibles los valores duplicados? (Sí, así que mantén la fusión estable si importa).
Fuerza bruta
Recolecta todos los valores en un arreglo, ordénalo y reconstruye una lista. El tiempo es O(N log N) y el espacio es O(N). Funciona, pero ignora que cada lista ya está ordenada, así que rara vez se acepta como respuesta final.
Enfoque 1: un min-heap
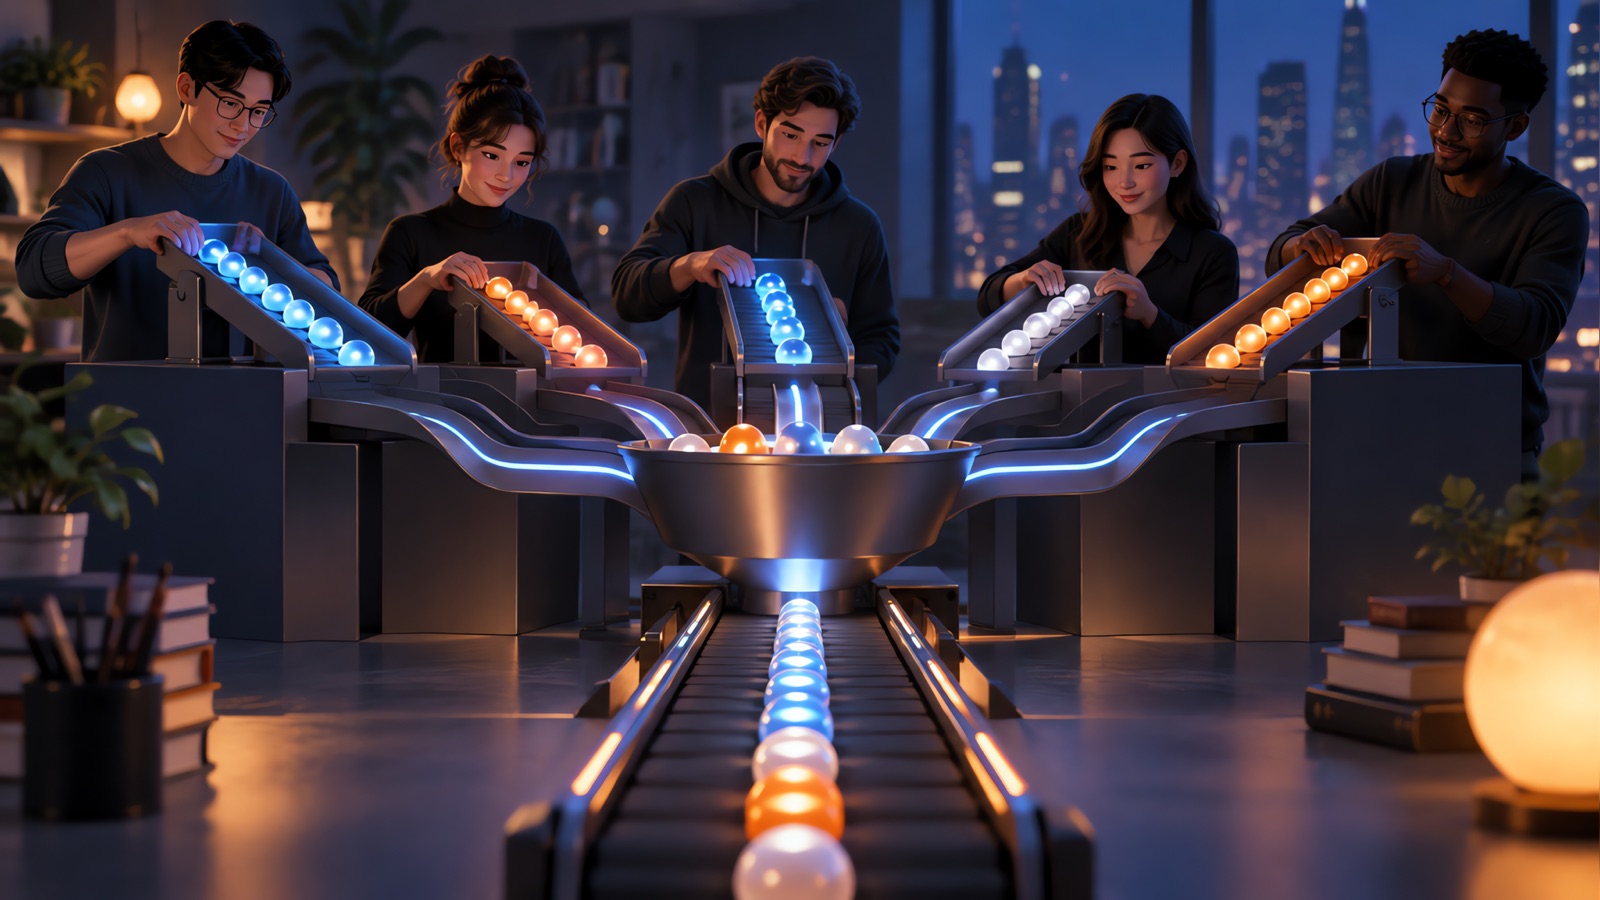
Mantén un puntero por lista. El siguiente nodo en la salida siempre es el más pequeño entre las cabezas actuales, así que mantén las cabezas en un min-heap.
- Inserta la cabeza de cada lista no vacía en el heap.
- Extrae la más pequeña, agrégala al resultado e inserta su siguiente nodo si existe.
- Repite hasta que el heap esté vacío.
import heapq

class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def merge_k_lists(lists):
    heap = []
    for i, node in enumerate(lists):
        if node:
            heapq.heappush(heap, (node.val, i, node))
    dummy = tail = ListNode()
    while heap:
        _, i, node = heapq.heappop(heap)
        tail.next = node
        tail = node
        if node.next:
            heapq.heappush(heap, (node.next.val, i, node.next))
    return dummy.next
El índice i es un desempate. Sin él, dos entradas con valores iguales harían que Python comparara objetos ListNode, lo que genera un TypeError.
Complejidad: cada uno de los N nodos entra al heap una vez y sale una vez, y cada operación cuesta O(log k), así que el tiempo es O(N log k). El heap contiene como máximo k nodos, así que el espacio extra es O(k).
Enfoque 2: divide y vencerás
Fusionar dos listas ordenadas es fácil y toma O(n) de tiempo. Fusiona las listas en pares, luego fusiona los resultados en pares, y así sucesivamente, como un torneo.
def merge_two(a, b):
    dummy = tail = ListNode()
    while a and b:
        if a.val <= b.val:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a or b
    return dummy.next

def merge_k_lists_dc(lists):
    if not lists:
        return None
    while len(lists) > 1:
        merged = []
        for i in range(0, len(lists), 2):
            other = lists[i + 1] if i + 1 < len(lists) else None
            merged.append(merge_two(lists[i], other))
        lists = merged
    return lists[0]
Complejidad: hay aproximadamente log k rondas, y cada ronda toca los N nodos una vez, así que el tiempo es O(N log k). La versión con bucle solo necesita O(1) de espacio extra aparte de la lista de cabezas.
¿Por qué no fusionar una por una?
Fusionar la lista 1 con la lista 2, luego el resultado con la lista 3, y así sucesivamente, parece natural pero cuesta más. La primera lista se copia a través de k fusiones. Si cada lista tiene n nodos, el trabajo total es aproximadamente n x (1 + 2 + ... + k), que es O(n k al cuadrado). Emparejar las listas mantiene los tamaños equilibrados, así que cada nodo se toca alrededor de log k veces.
Comparación de los dos
| Min-heap | Divide y vencerás | |
|---|---|---|
| Tiempo | O(N log k) | O(N log k) |
| Espacio extra | O(k) | O(1) con la versión con bucle |
| Código | Corto, necesita un desempate | Reutiliza merge_two |
| Bueno cuando | Las listas llegan como streams o solo necesitas los primeros resultados | Tienes todas las listas en memoria |
Si un entrevistador dice que las listas son demasiado grandes para la memoria y llegan como streams, el enfoque con heap se extiende de forma natural, ya que solo necesita la cabeza actual de cada stream.
Casos límite para probar
| Entrada | Esperado |
|---|---|
| [] | None |
| [None] | None |
| [None, None] | None |
| Una lista no vacía | Esa lista |
| Valores duplicados entre listas | Todos conservados, en orden |
| Números negativos | Se manejan igual |
| Longitudes muy desiguales | Se manejan, ya que la lista restante se adjunta al final |
Cómo explicarlo en una entrevista
- Menciona la fuerza bruta y por qué es un desperdicio.
- Di la observación clave: el siguiente nodo de salida es la cabeza actual más pequeña.
- Elige el heap, escríbelo y menciona el desempate.
- Indica la complejidad: O(N log k) de tiempo y O(k) de espacio.
- Ofrece divide y vencerás como la alternativa con O(1) de espacio.
- Prueba con una entrada vacía y una con duplicados.
Probé ambas versiones anteriores contra una verificación basada en ordenamiento en 3.000 entradas aleatorias, incluidas listas vacías, antes de publicar. Hacer una verificación aleatoria rápida como esa es un buen hábito cuando practicas.
Práctica relacionada
Si esto te resultó fácil, intenta primero Fusionar dos listas ordenadas, luego Ordenar lista y Encontrar la mediana del flujo de datos, que usan las mismas ideas. Consulta nuestra guía rápida de Big O para los términos de complejidad, la guía de subcadena común más larga para programación dinámica, y la guía del asistente para entrevistas de programación para saber cómo practicar.
Explica tu enfoque en voz alta mientras programas. Una transcripción de entrevista simulada muestra si explicaste la observación clave antes de escribir. Sigue las reglas del empleador sobre herramientas de IA en cualquier evaluación en vivo.
Practica entrevistas de programación con YesToTheOffer
Realiza una entrevista simulada de programación, explica tu enfoque en voz alta y revisa tu transcripción después. 30 minutos gratis, sin suscripción.